2008年2月18日 星期一

PC Assembly Language 學習筆記(7) - Subprograms

Indirect Addressing

indirect address 的用途是在於讓 register 以類似 pointer 的方式來運作,而使用方式上必須用中括號([])包住 register 名稱,以下舉例說明:
mov     ax, [myData]    ;指定以類似 pointer 方式處理
mov ebx, myData ;EBX = &myData
mov ax, [ebx] ;AX = *EBX


The Stack

現在幾乎大多數 CPU 中都已經支援 stack 了,其特色在於 LIFO(Last In First Out),因此在程式中常被用來作為資料暫存以及呼叫 subprogram 之用,

以下分別舉兩個例子說明:

資料暫存

在資料暫存的部分,必須透過 PUSH、POP 兩個指令以及 ESP(stack pointer) register 的搭配;其中 PUSH 會將 ESP 中的位址 - 4,並將內容塞入 [ESP] 的位址;而 POP 則會將 ESP 中的位址 + 4,並將內容塞到指定的地方去;以下用範例來說明:
;假設 EPS 一開始儲存的 memory address 為 0x1000
push dword 1 ;將 1 存於 0x0FFC 的位置,ESP = 0x0FFC(0x1000 - 0x0004)
push dword 2 ;將 2 存於 0x0FF8 的位置,ESP = 0x0FF8(0x0FFC - 0x0004)
push dword 3 ;將 3 存於 0x0FF4 的位置,ESP = 0x0FF4(0x0FF8 - 0x0004)
pop eax ;EAX = 3,ESP = 0x0FF8(0x0FF4 + 0x0004)
pop ebx ;EBX = 2,ESP = 0x0FFC(0x0FF8 + 0x0004)
pop ecx ;ECX = 1,ESP = 0x1000(0x0FFC + 0x0004)
【註】PUSH 的資料長度必須是 double word

呼叫 subprogram

若要透過 stack 來呼叫 subprogram,則必須使用 CALL 與 RET 兩個指令,其中 CALL 為 unconditional jump,會直接跳到所指定的 Label,並將原本他所在的 memory address push 到儲存下一個執行指令位址的 stack 中;而 RET 則是將 stack 中的 memory address pop 出來,並跳回該 memory address。以下用個範例說明:
mov     ebx, input1
;uncondictional jump,跳至 get_int 所在位址,並將原本的 memory address push 到儲存下一個執行指令的 stack 中
call get_int

mov ebx, input2
;uncondictional jump,跳至 get_int 所在位址,並將原本的 memory address push 到儲存下一個執行指令的 stack 中
call get_int

get_int:
call read_int
mov [ebx], eax
ret ;將原本呼叫 subprogram 時所在的 memory address 從 stack pop 出來,以返回呼叫點
透過此種方式,呼叫 subprogram 就更為方便了!


Calling Conventions

在其他高階程式語言中,常常會在呼叫 subprogram 時帶入多個參數,這在底層是如何處理的呢? 答案就是利用 stack。

由於參數資料會在 subprogram 中被使用一次甚至數次,因此這些資料不適合放置於 register 中,因此一般會放在 stack 中;而且會在 CALL 指令發生前先 push 進入 stack 中,因此 return address 也會比參數先從 stack 中 pop 出來。以下用一張圖來說明:
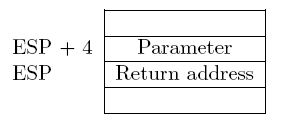

但如果在 subprogram 中又有資料要存入 stack 中呢? 在 stack 中的情形會變成如下:
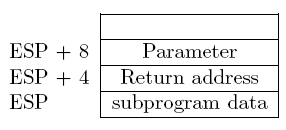
如此一來,參數的位置就從 [ESP+4] 的位置跑到 [ESP+8] 了,若是在 subprogram 中要使用到 stack,就必須注意參數被移到那個位置去,其實蠻麻煩的。

因此,在 80386 以後的 CPU,提供了 EBP(base pointer) register 來解決這個問題,而 EBP 所儲存的內容,則是對應到 return address 所存放的位置(因此一開始 EBP 的內容要設定與 ESP 相同)。

以下用個簡單範例說明 EBP 在 subprogram 中的使用方式:
subprogram_label:
push ebp ;將 EBP 的內容先存到 stack 中
mov ebp, esp ;EBP = ESP
;subprogram 的實作內容置於此處
pop ebp ;還原 EBP 的值
ret
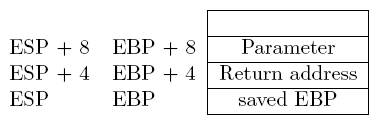
透過以上這一段程式的使用,ESP 與 EBP 的關係會變成如下圖:

之後若要取得參數的內容,不管 stack 中已經塞了多少 subprogram 的資料,只要用 [EBP+8] 就可以取得參數的內容囉!

以下用個範例來進行以上說明的總結:
%include "asm_io.inc"

segment .data
sum dd 0 ;定義記憶體空間,長度為 double word

segment .bss
input resd 1

;
; pseudo-code algorithm
; i = 1;
; sum = 0;
; while(get_int(i, &input), input != 0) {
; sum += input;
; i++;
; }
; print_sum(sum);
segment .text
global asm_main
asm_main:
enter 0, 0
pusha

mov edx, 1 ;將 EDX 視為變數 i
while_loop:
push edx
push dword input
call get_int
add esp, 8 ;將 i 與 &input 從 stack 中清除

;判斷輸入的值是否為 0
mov eax, [input]
cmp eax, 0
je end_while

add [sum], eax ;sum += input

inc edx ;i++
jmp while_loop ;繼續執行下一個迴圈

end_while:
push dword [sum] ;將 [sum] 存入 stack 中
call print_sum
pop ecx ;將 [sum] 從 stack 中清除

popa
leave
ret


;subprogram: get_int
;參數(根據順序放入 stack 中)
; 1、輸入的值(位於 [EBP + 12])
; 2、輸入資料所存放的位址(位於 [EBP + 8])
;[EBP] 儲存原本 EBP 中的內容
;[EBP + 4] 儲存 return address
;[EBP + 8] 之後開始儲存參數的相關內容,因為有兩個參數,因此 ESP 要存取第一個參數就必須指向 [EBP + 12]
;注意:
; 在 EAX 與 EBX 中的資料將會被清除
;
segment .data
prompt db ") Enter an integer number (0 to quit): ", 0

segment .text
get_int:
push ebp ;將 EBP 內容暫時存於 stack 中
mov ebp, esp

mov eax, [ebp + 12] ;上面的程式會將 EDX 的值塞到 [EBP + 12] 所儲存的 memory address 中
call print_int ;印出輸入第幾個數字

mov eax, prompt
call print_string

call read_int
mov ebx, [ebp + 8] ;上面的程式會將 input 所在的 memory address 塞到 [EBP + 8],因此 EBP 儲存的為 memory address 而不是整數
mov [ebx], eax ;以類似 pointer 方式將 EAX 的值存到 EBX 所儲存的 memory address 上

pop ebp ;回復 EBP 中的值
ret


;subprogram: print_sum
; 印出總和
;參數:
; (1)所要輸出的總和(位於 [EBP + 8])
;注意:
; 在 EAX 中的資料將會被清除
;
segment .data
result db "The sum is ", 0

segment .text
print_sum:
push ebp
mov ebp, esp

mov eax, result
call print_string

mov eax, [ebp + 8]
call print_int
call print_nl

pop ebp
ret

Local variables on the stack


在 subprogram 中,難免會使用到 local 變數,一般都是利用 stack 來處理 local 變數(例如:C 語言),local 變數儲存的地方在原本 EBP 儲存位置之後,以下用一張圖來說明:
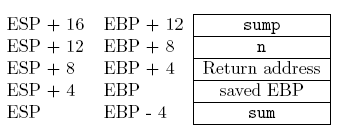
(其中 sum 即為 local 變數)

若要取得第一個 local 變數,可透過 [ESP - 4](此時 ESP 指到 EBP 的地方,也就是 +4 的位置),而在 subprogram 中使用 local 變數的方法,可以使用類似以下的程式碼:
subprogram_label:
push ebp
mov ebp, esp
sub esp, LOCAL_BYTES ;在此處根據需求保留給 local 變數的空間
;subprogram 的實作內容置於此處
mov esp, ebp
pop ebp
ret
以下用一個較為完整的範例來說明:
; (C 語言程式碼)
; void calc_sum(int n, int *sump) {
; int i, sum = 0;
;
; for(i = 1 ; i <= n ; i++)
; sum += i;
;
; *sump = sum;
; } //end calc_sum
calc_sum:
push ebp
mov ebp, esp
sub esp, 4 ;保留儲存 local 變數的 memory address 的空間

mov dword [ebp - 4], 0 ;sum = 0;
mov ebx, 1 ;假設 EBX = i

for_loop:
cmp ebx, [ebp + 8] ;i <= n
jnle end_for ;jump if not(less & equal)

add [ebp - 4], ebx ;sum += i
inc ebx
jmp short for_loop

end_for:
mov ebx, [ebp + 12] ;ebx = sump
mov eax, [ebp - 4] ;eax = sum
mov [ebx], eax ;*sump = sum

mov esp, ebp
pop ebp
ret


Multi-Module Programs

所謂的 multi-module program 是由多個 object file 所組合而成的,而之前下一堆指令所產生的執行檔,就是屬於 multi-module program。

而當程式大一點時,總是希望可以將其進行模組化的設計,將龐大的程式拆開成為較小容易閱讀及 debug 的多個檔案,在 assembly 中,可以透過 extern 以及 global 兩個關鍵字。

external

以下先用一段範例程式說明:
extern  read_int, print_int, print_string
extern read_char, print_char, print_nl
extern sub_dump_regs, sub_dump_mem, sub_dump_math, sub_dump_stack
透過 extern 的宣告,用來告知 assembler 以上這些 subprogram 的定義位於外部的檔案中,不在這個檔案中。

不過在編譯的階段必須將包含定義這些 subprogram 的檔案一併加入編譯,否則會產生編譯時的錯誤。

global

global 在之前的每一支程式都會使用到,用意是讓其他的 module 可以直接呼叫使用 global 關鍵字宣告的 module。

使用範例說明

了解兩個關鍵字的使用方式後,接著以下介紹其使用方式:
; ==================== main4.asm ====================
%include "asm_io.inc"

segment .data
sum dd 0

segment .bss
input resd 1

segment .text
global asm_main ;宣告為 global,才可以由 C 程式中直接呼叫使用
extern get_int, print_sum ;宣告為 extern,表示這兩個 subprogram 的定義存在於其他檔案中

asm_main:
enter 0, 0
pusha

mov edx, 1
while_loop:
push edx
push dword input
call get_int
add esp, 8 ;清除兩個參數的內容

mov eax, [input]
cmp eax, 0
je end_while

add [sum], eax ;sum += [input]

inc edx
jmp short while_loop

end_while:
push dword [sum]
call print_sum ;印出在 stack 中的 sum
pop ecx

popa
leave
ret


; ==================== sub4.asm ====================
%include "asm_io.inc"

segment .data
prompt db ") Enter an integer number (0 to quit): ", 0

segment .text
global get_int, print_sum

get_int:
enter 0, 0

;saved EBP(EBP) + return address(EBP + 4) + &input(EBP + 8) + i(EBP + 12)
mov eax, [ebp + 12] ;第一個參數(i)
call print_int

mov eax, prompt
call print_string

call read_int
mov ebx, [ebp + 8] ;取得資料所要儲存的 memory address
mov [ebx], eax ;將資料存於指定的 memory address

leave
ret


segment .data
result db "The sum is ", 0

segment .text
print_sum:
enter 0, 0

mov eax, result
call print_string

;saved EBP(EBP) + return address(EBP + 4) + sum(EBP + 8)
mov eax, [ebp + 8]
call print_int
call print_nl

leave
ret
編譯與執行可用下列指令:
shell> nasm -f elf main4.asm ; nasm -f elf sub4.asm ; gcc -o main4 driver.c main4.o sub4.o asm_io.o; ./main4


Interfacing Assembly with C

之前有提過,由於目前的 compiler 越來越完善,因此編譯出來的 machine code 效能不見得會輸給直接寫 assembly,因此現在已經很少所有程式都使用 assembly 開發了,大多都是在 performance tunning 時,或是需要直接控制到硬體時,才會撰寫 assembly。

因此在使用時,通常都是 C 與 assembly 混合使用,不過有些事情是必須了解的,例如:
  1. C 語言中在 subroutine 中通常都會維護 EBX、ESI、EBP、CS、DS、SS、ES .... 等 register 的值,不會去更動他(但不代表不能更動,只是必須要回復,通常用 stack 來儲存這些 register 中的值)
  2. C 語言中 global 或 static 的 function 或變數名稱前都會加上底線(_),這跟 assembly 中加上底線是不同的意思
  3. 在參數的傳遞上,C call convention 規定 function 中的參數是以反向的順序塞入 stack 中;因此,第一個參數位於 [EBP + 8],第二個參數位於 [EBP + 12] (原本第一個參數位於 [EBP + 12],第二個參數位於 [EBP + 8])
  4. 回傳值的部分大多都是透過將值存於 register 的方式來達成,可能存於 EAX、EDX:EAX、或是 ST0 中
  5. 程式中可以指定不同的 call convention,一般的 compiler 都會支援多種 calling convention

以下用個範例說明 C 與 assembly 的搭配:
// ==================== main5.c ====================
#include <stdio.h>

void calc_sum(int, int *) __attribute__((cdecl));

int main(void) {
int n, sum;

printf("Sum integer up to: ");
scanf("%d", &n);
calc_sum(n, &sum);
printf("Sum is %dn", sum);

return 0;
} //end main


;==================== sub5.asm ====================
%include "asm_io.inc"

; subroutine: calc_sum
; 目的: 計算從 1~n 的加總
; 參數:(因為 C calling convention 的關係,因此參數以反向的順序存入 stack 中)
; (1)加總的上限(即為n) [EBP + 8]
; (2)指向儲存加總資料位址的 pointer [EBP + 12]
; pseudo C code:
; void calc_sum(int n, int *sump) {
; int i, sum = 0
; for(i = 1 ; i <= n ; i++)
; sum += i;
; *sump = sum;
; } //end calc_sum

segment .text
global calc_sum

;local variable:
; sum => [ebp - 4]
calc_sum:
enter 4, 0 ;在 stack 中預留空間給 sum 使用
push ebx

mov dword [ebp - 4], 0
dump_stack 1, 2, 4
mov ecx, 1

for_loop:
cmp ecx, [ebp + 8] ;i <= n ?
jnle end_for

add [ebp - 4], ecx
inc ecx
jmp short for_loop

end_for:
mov ebx, [ebp + 12] ;EBX = sump (儲存加總結果的 pointer)
mov eax, [ebp - 4] ;EAX = sum (加總結果)
mov [ebx], eax ;使用 [pointer] 指定該 memory address 儲存的資料為 sum

pop ebx
leave
ret

然而,從 C 可以呼叫 assembly code,當然也可以在 assembly 中使用 C library 囉! 這個部分下個章節會繼續討論囉!!

2008年2月15日 星期五

PC Assembly Language 學習筆記(6) - Bit Operations

Shift Operations

bit shift 分為三種,分別是 logical shift(用於 unsigned integer)、arithmetic shift(用於 signed integer) 以及 rotate shift

Logical Shift 所用的指令為 SHR(向右位移) 與 SHL(向左位移),位移的最後一個 bit 會存於 carry flag 中。

Arithmetic Shift 所用的指令為 SAL 與 SAR,專門用來處理 signed integer。

【註】Logical Shift 與 Arithmetic Shift 常用於乘二與除二的計算上,速度比 MUL 和 DIV 快上許多!

Rotate Shift 則是將所有 bit 的集合視為一個環狀佇列進行位移,所用的指令為 ROL、ROR、RCL(carry flag 也算佇列中一員)、RCR(carry flag 也算佇列中一員)。

三種 bit shift 的語法都相同,將要位移的資料搬到 register 後,使用類似下方的指令:
# 將 AX register 中的資料向右位移 1 的 bit
shr ax, 1


Boolean Bitwise Operations

最常用的 boolean operation 有 AND、OR、NOT、XOR 四種,在 assembly 中指令也是相同的名稱,使用方式就是將要處理的資料搬入 register 中,再跟另外一個數值或 register 進行 boolean operation。

以下舉個範例:
mov ax, 0x123H or ax, 0E831H
但有幾點必須要注意,NOT 使用後可取得該數值的 1 補數,且不會改變 EFLAGS register 中的值。

另外,AND、OR、XOR 的用途通常在於:
  • AND:關閉某幾個 bit
  • OR:打開某幾個 bit
  • XOR:取得指定 bit 的補數(特殊用法:同樣數值進行 XOR 結果為 0)


Avoiding Conditional Branches

一般在程式中會有許多條件判斷,而 CPU 中有特定的單元可以負責預測程式的走向(不一定每次會準確),若是太多條件判斷,CPU 誤判的機會就越高,執行效率也就越差。

因此,在 assembly 的撰寫中可以避免 conditional branch 的情況發生,可以用 SETxx 指令,以下用個範例來說明:
;檔案: max.asm
;描述:求兩數之間較大的數

%include "asm_io.inc"

segment .data
message1 db "Enter a number: ", 0
message2 db "Enter another number: ", 0
message3 db "The larger number is ", 0

segment .bss
input1 resd 1 ;第一個輸入的數字

segment .text
global asm_main
asm_main:
enter 0, 0
pusha

mov eax, message1 ;取得使用者第一個輸入的整數值
call print_string
call read_int
mov [input1], eax

mov eax, message2 ;取得使用者第二個輸入的整數值
call print_string
call read_int

;一連串為了取得兩數之間的較大值所必須要作的處理
xor ebx, ebx ;EBX=0
cmp eax, [input1] ;比較的結果會影響後續程式的進行
setg bl ;EBX = (input2 > input1) ? 1 : 0 (set 1 if greater)
neg ebx ;EBX = (input2 > input1) ? -1(0xFFFFFFFF) : 0
mov ecx, ebx ;ECX = (input2 > input1) ? -1(0xFFFFFFFF) : 0
and ecx, eax ;ECX = (input2 > input1) ? [intpu2] : 0
not ebx ;EBX = (input2 > input1) ? 0 : -1(0xFFFFFFFF)
and ebx, [input1] ;EBX = (input2 > input1) ? 0 : [input1]
or ecx, ebx ;ECX = (input2 > input1) ? input2 : input1

mov eax, message3
call print_string
mov eax, ecx
call print_int
call print_nl

popa
mov eax, 0 ;回到 C 程式
leave
ret


Big and Little Endian Representations

假設要表示 double word - 0x12345678,兩種表示法分別如下:
  • Big Endian:0x 12 34 56 78
  • Little Endian:0x 78 56 34 12

通常會需要注意到 big/little endian 問題是在寫 TCP/IP 相關程式的時候,在 C 語言中,提供了 htonl() 與 ntohl() 兩個 function 作為 network byte order 與 host byte order 之間的轉換。

而在 486 的 CPU 中提供了兩個指令用來可以反轉 32-bit register 與 16-bit register 的 byte order 之用,以下為使用範例:
#用於 32-bit register
bswap edx

#用於 16-bit register(將 AH 與 AL 對調)
xchg ah, al

2008年2月11日 星期一

PC Assembly Language 學習筆記(5) - Control Structures

Comparisons

在 assembly 中,若要進行資料的比較,必須使用 CMP 指令,以下是 CMP 指令的使用方式:
cmp vleft, vright
CMP 指令作的,其實就是 vleft - vright,並將比較後的結果存入 EFLAGS register 中(使用到 zero、carry、sign 三個 flag),以下進行詳細的說明:

unsigned integer

對於 unsigned integer 的比對,會使用到 ZF(zero falg) 與 CF(carry flag) 兩個 flag,會有以下三種情況:
  1. vleft = vright
    相減後結果為 0,因此 ZF=1;不會有借位的情形,因此 CF=0
  2. vleft > vright
    相減後結果大於 0,因此 ZF=0;不會有借位的情形,因此 CF=0
  3. vleft < vright
    相減後結果小於 0,因此 ZF=0;會有借位的情形,因此 CF=1

signed integer

對於 signed integer 的比對,則會使用到 ZF(zero flag)、OF(overflow flag) 與 SF(sign flag) 三個 flag,也是會有三種情況:
  1. vleft = vright
    相減後結果為 0,因此 ZF=1;不會有借位的情形,因此 CF=0;結果不為負,因此 SF=0
  2. vleft > vright
    相減後結果大於 0,因此 ZF=0;且 CF=SF
  3. vleft < vright
    相減後結果小於 0,因此 ZF=0;且 CF<>SF

當然會改變 EFLAGS 內容的不僅是 CMP 指令而已,不過若是要進行類似 if 的動作,就必須使用上面的方式。


Branch instructions

branch 指令在 assembly 中,作用就類似高階語言中的 goto,型態有分為兩種,分別是:
  1. unconditional branch
    類似 goto,沒有任何條件判斷就會進行跳躍
  2. conditional branch
    根據 EFLAGS register 中的特定 flag 來決定是否進行跳躍

在 unconditional branch 中,最常用的即為 JMP(Jump) 指令,可以指定跳躍至哪一個 code label 所在的位置,而 JMP 有分為不同三種類型:
  1. SHORT
    此種僅能從所在位置前後跳躍 128 bytes 長度的空間,僅使用一個 signed byte 儲存跳躍的長度與位置,優點是節省記憶體空間。
  2. NEAR
    這是 unconditional/conditional branch 所預設的跳躍類型,可跳躍至同一個 code segment 中的任何空間,最大可跳躍 2(28*2)bytes 或 4 bytes(28*4預設) 可表示長度的空間。
    另外若是指定要跳躍 2 bytes 可表示長度的空間,必須在 JMP 與 code label 之間放入 WORD 關鍵字。
  3. FAR
    可跳躍至不同的 code segment。

接著說到 conditional branch,是依靠在 EFLAGS register 中的特定 bit 來決定是否進行跳躍的,以下用張簡單的圖表來說明:

其中 ZF(zero flag)、OF(overflow flag)、SF(signed flag)、CF(carry flag) 之前都已經有提過,而 PF(parity flag) 則是根據計算結果的 lower 8 bits 中,有奇數或偶數個 bit 被設定為 1 來決定是否設定此 flag。

以下用幾段簡單的範例程式來說明:
;高階程式的撰寫方式
if(EAX == 0)
EBX = 1;
else
EBX = 2;

;轉換為以下的 assembly code
cmp eax, 0 ;比較 EAX 與 0(若相同則 ZF=0,不相同則 ZF=1)
jz thenblock ;ZF=0,跳躍至 thenblock
mov ebx, 2 ;EAX<>0,因此 EBX=2
jmp next ;if 判斷完畢
thenblock:
mov ebx, 1 ;EAX=0,因此 EBX=1
next:
;高階程式的撰寫方式
if(EAX >= 5)
EBX = 1;
else
EBX = 2;

;轉換為以下的 assembly code
cmp eax, 5 ;比較 EAX 與 5(若 EAX=5 則 ZF=1;EAX>5 則 ZF=0, CF=SF)
js signon ;SF=1
jo elseblock ;SF=0, OF=1 (表示 EAX < 5)
jmp thenblock ;SF=0, OF=0 (表示 EAX >= 5)

signon:
jo thenblock ;SF=1, OF=1 (表示 EAX > 5)
elseblock:
mov ebx, 2
jmp next
thenblock:
mov ebx, 1
next:

從上面程式看得出來,真的不是很容易理解,更別說是撰寫了,不過幸好 80x86 提供了一些更簡單的寫法,以下用一張圖表來說明:

以下舉個例子,相信上面的表會比較容易看懂。
#JL(Jump if less than) 等於 JNGE(jump if not greater than and not equal to)
x < y => not(x >= y)
因此上面的程式修改如下:
;高階程式的撰寫方式
if(EAX >= 5)
EBX = 1;
else
EBX = 2;

;轉換為以下的 assembly code
cmp eax, 5
jge thenblock
mov ebx, 2
jmp next
thenblock:
mov ebx, 1
next:


The loop instructions

迴圈(loop)在程式開發中是絕對不可或缺的一環,在 assembly 中,loop 的使用並不困難,指令大致有以下三種:
  1. LOOP
    ECX - 1,若 ECX <> 0,繼續下一個迴圈
  2. LOOPE、LOOPZ
    ECX - 1,若 ECX <> 0 且 ZF=1,繼續下一個迴圈
  3. LOOPNE、LOOPNZ
    ECX - 1,若 ECX <> 0 且 ZF=0,繼續下一個迴圈

後兩個 loop 常用於 sequential search 中。

以下用一段範例程式來說明:
;高階程式的撰寫方式
sum = 0;
for(i = 10 ; i > 0 ; i--)
sum += i

;轉換為以下的 assembly code
mov eax, 0
mov ecx, 10
loop_start:
add eax, ecx
loop loop_start


Translating Standard Control Structures

以下要用幾個範例來展示如何將高階語言中的流程控制語法轉換為 assembly code:

IF
;高階程式的撰寫方式
if( condition )
then_block;
else
else_block;

;轉換為以下的 assembly code(兩個分號表示程式擺放的位置)
;;此處擺放用來設定 EFLAGS register 內容的程式
;;例如:cmp xx, xx
jxx else_block ; 判斷為 false
;; 判斷為 true 後所要執行的程式碼
jmp end_if
else_block:
;; 判斷為 false 後所要執行的程式碼
end_if:
while loops
;高階程式的撰寫方式
while( condition ) {
迴圈執行的內容;
}

;轉換為以下的 assembly code(兩個分號表示程式擺放的位置)
while:
;;此處擺放用來設定 EFLAGS register 內容的程式
;;例如:cmp xx, xx
jxx end_while ; 判斷為 false,結束迴圈
;; 迴圈執行的內容
jmp while
end_while:
do while loops
;高階程式的撰寫方式
do {
迴圈執行的內容;
} while( condition );

;轉換為以下的 assembly code(兩個分號表示程式擺放的位置)
do:
;; 迴圈執行的內容
;;此處擺放用來設定 EFLAGS register 內容的程式,例如:cmp xx, xx
jxx do ; 判斷為 true,繼續執行迴圈


範例程式(求質數)

接著介紹求質數的範例,以下為 C code:


接著以下為 assembly code:
;檔案: prime.asm
;描述:求質數

%include "asm_io.inc"

;初始化資料
segment .data
Message db "Find primes up to: ", 0

;未初始化資料
segment .bss
Limit resd 1 ;尋找質數的上限
Guess resd 1 ;目前正在處理判斷的數值

segment .text
global asm_main
asm_main:
enter 0, 0 ;程式開始
pusha

mov eax, Message ;印出訊息
call print_string
call read_int ;讀取使用者輸入的數值,存入 Limit
mov [Limit], eax

mov eax, 2 ;印出 2 與 3
call print_int
call print_nl
mov eax, 3
call print_int
call print_nl

mov dword [Guess], 5

while_limit:
mov eax, [Guess]
cmp eax, [Limit] ;比較 Guess 與 Limit
jnbe end_while_limit ;Guess > Limit,程式結束

mov ebx, 3 ;在 EBX 中設定第一個因數(factor)為 3

while_factor:
mov eax, ebx
mul eax ;EDX:EAX = EAX * EAX
jo end_while_factor ;EAX 相乘後的值無法存入 32-bit 的 EAX register(註解也無所謂,只要不要輸入過大的值即可)
cmp eax, [Guess]
jnb end_while_factor ;if !(factor * factor < guess)
mov eax, [Guess]
mov edx, 0
div ebx ;EDX = EDX:EAX % EBX
cmp edx, 0 ;檢查餘數是否為 0
je end_while_factor ;if(guess % factor == 0)

add ebx, 2 ;factor += 2
jmp while_factor

end_while_factor:
je end_if
mov eax, [Guess] ;印出質數
call print_int
call print_nl

end_if:
add dword [Guess], 2 ;guess + 2
jmp while_limit

end_while_limit:
popa
mov eax, 0 ;回到 C 程式
leave
ret

2008年2月8日 星期五

PC Assembly Language 學習筆記(4) - Working with Integer

整數表示法

在電腦系統中,根據有無正負號,分為 unsigned 與 signed;在 unsigned 的部分就不需太多討論了,因為就很直覺的進行換算即可,而 signed 的部分,在電腦系統中是使用 2 補數的方式來表示。

2 補數的換算很簡單,只要先換成 1 補數(0 1 對調),再加上 1 即為 2 補數;使用 2 補數除了有表示範圍較大之外,CPU 也較容易處理;而在 assembly 中若是要計算 2 補數,可以用 NEG 這個指令,可以直接將指定的運算子轉換為 2 補數(運算元可以是 register 或是 memory address)。

另外,對 CPU 來說,並不知道要資料的長度為何(完全不知道所處理的是 byte、word、還是 double word),因此程式設計師若要指定處理資料的大小,就必須仰賴所使用的指令。


signed extension

在 assembly 中,所有的資料都會有其大小,根據程式需求改變資料程度是很平常的事情,以下給的例子:
;AX = 0x134(長度為 16 bits)
;AX = 308
mov ax, 0134H
;將 AX register 中的 lower 8 bits 放入 CL register 中
;CL = 0x34(長度為 8 bits)
;CL = 52
mov cl, al
從上面例子可看出,由於資料大小改變了,因此其值也改變了。

另外,若要加大資料的長度可就不是這麼簡單了,舉個例子來說,假設有一個值為 0xFF,要從原本的 8 bits 轉為 16 bits,若是 unsigned integer 倒也是簡單,但若是 signed integer,那可就不是隨便前面補 0 就可以完成的了!

在 80386 系列的 CPU,提供了多個指令可以進行擴充資料長度這一類的工作,以下用範例來說明:
;以下指令僅用於 unsigned integer
;destination 的長度必須大於 source
movzx eax, ax ;複製 AX 的內容到 EAX (16 bits -> 32 bits)
movzx eax, al ;複製 AL 的內容到 EAX (8 bits -> 32 bits)
movzx ax, al ;複製 AL 的內容到 AX (8 bits -> 16 bits)
movzx ebx, ax ;複製 AX 的內容到 RBX (16 bits -> 32 bits)
如註解上說明,movzx 指令僅能用於 unsigned integer,而若是要擴充 signed integer 的長度,在 8086 下可使用以下指令:(此時僅有 16-bit register)
  • CBW(Convert Byte to Word)
    將 AL register 中的資料加以擴充轉換後,存入 AX register 中
  • CWD(Convert Word to Double word)
    將 AX register 中的資料加以擴充轉換後,分成兩組存入 DX 與 AX register 中,變成 DX:AX (32 bits)

若在 80386 以後,則提供了以下指令:
  • CWDE(Convert Word to Double word extended)
    將 AX register 中的資料加以擴充轉換後,存入 EAX register 中
  • CDQ(Convert Double word to Quad word)
    將 EAX register 中的資料加以擴充轉換後,分成兩組存入 EDX 與 EAX register 中,變成 EDX:EAX (64 bits)

此外還多提供了 MOVSX 的指令,用法語 MOVZX 相同,但可以用來搬移 signed integer。


與 C 語言的對照

上面說了一堆 unsigned/signed,在 C 語言中又是如何呢? 以下用程式來說明:

在 C 語言中,char 為 1 byte,而 int 為 4 bytes;以上程式轉為 assembly 應該是怎麼作呢?

unsigned char -> integer,使用 MOVZX (此指令用於 unsigned integer)

signed char -> integer:使用 MOVSX (此指令用於 signed integer)


然而有沒有指定 unsigned 或是 signed 真的很重要嗎? 以下用另外一段程式來說明:

仔細看 while 執行的條件,必須判斷 char 並非 EOF(-1) 才會繼續執行。

而 char 要與 integer 作比較,就必需要經過 extend 的動作;然而,若是遇到 EOF 字元為 0xFF,在 unsigned/signed 兩種不同情況下,會擴充為:
  • unsigned => 0x000000FF
  • signed => 0xFFFFFFFF (因為 signed char 0xFF 為 -1)

若是 unsigned 的情況下,原本的 EOF char 會被轉為 255 而非 -1,如此一來結果就不對了! 所以,C 語言中預設變數都是 signed 原因即是如此。


2 補數的四則運算

加法(addition)、減法(subtraction)

2 補數有一個很大的優點,就是不論 unsigned 或是 signed,進行加法(ADD)或減法(SUB)的方式都是相同的。

但在進行加減法運算時,會影響到 EFLAGS register 中的兩個 bit,分別是 overflow 以及 carry,以下說明一下相關情況:
  1. 針對 signed 數值運算,若 destination 空間不夠存放計算出來的結果,則 overflow=1,反之則為 0
  2. 若計算中產生借位或溢位的情況,則 carry=1,反之為 0

以下用一個算式說明 carry 的發生:


乘法(multiply)

為了處理 unsigned 以及 signed 的問題,乘法的部分有兩種指令,分別是 MUL(用於 unsigned) 與 IMUL(用於 signed)。

MUL 的用法如下:
mul source
結果會有三種,分別是:(source 也可以是相同大小的 memory 位址)
  1. source 為 AL(8 bits) 中的值,則結果會存在 AX(16 bits) register 中
  2. source 為 AX(16 bits) 中的值,則結果會存在 DX:AX(32 bits) 中
  3. 若 source 為 EAX(32 bits),則結果會存在 EDX:EAX(64 bits) 中。

而 IMUL 就是負責處理 signed 的部分,IMUL 的用法有以下幾種:
imul source1
imul dest, source1
imul dest, source1, source2
這樣一來使用組合就有很多種了,以下用一張圖來說明:


除法(devide)

除法與乘法是差不多的,針對 unsigned 與 signed 也都有兩種不同的指令,分別是 DIV(用於 unsigned) 與 IDIV(用於 signed)。

而除法的部分就牽涉到商數(quotient)和餘數(remainder)的部分,不過最重要的則是除數(source),以下說明一下除法的規則:
  1. source(除數) 為 8 bits,則要將被除數存放在 AX 中,最後 quotient 存於 AL 中,remainder 存於 AH 中
  2. source(除數) 為 16 bits,則要將被除數分成兩個部分存放在 DX:AX 中,最後 quotient 存於 AX 中,remainder 存於 DX 中
  3. source(除數) 為 32 bits,則要將被除數分成兩個部分存放在 EDX:EAX 中,最後 quotient 存於 EAX 中,remainder 存於 EDX 中

而 IDIV 的用法跟 DIV 是相同的,不像 IMUL 有另外不同的用法。


四則運算說明完後,當然要來個範例囉! 以下有個簡單的範例程式:
;檔案: math.asm
;描述:四則運算練習

%include "asm_io.inc"

;初始化資料
segment .data
prompt db "Enter a number: ", 0
square_msg db "Square of input is ", 0
cube_msg db "Cube of input is ", 0
cube25_msg db "Cube of input times 25 is ", 0
quot_msg db "Quotient of cube/100 is ", 0
rem_msg db "Remainder of cube/100 is ", 0
neg_msg db "The negation of the remainder is ", 0

;未初始化資料
segment .bss
input resd 1

segment .text
global asm_main
asm_main:
enter 0, 0 ;程式開始
pusha

;顯示提示訊息
mov eax, prompt
call print_string

;讀取使用者輸入的整數
call read_int
mov [input], eax

imul eax ;edx:eax = eax * eax
mov ebx, eax ;將相乘後的結果暫時存放於 EBX 中

;顯示[intput]^2的結果
mov eax, square_msg
call print_string
mov eax, ebx
call print_int
call print_nl

;顯示[intput]^3的結果
mov ebx, eax
imul ebx, [input] ;ebx *= [input]
mov eax, cube_msg
call print_string
mov eax, ebx
call print_int
call print_nl

;顯示[intput]^3 * 25的結果
imul ecx, ebx, 25
mov eax, cube25_msg
call print_string
mov eax, ecx
call print_int
call print_nl


mov eax, ebx
cdq ;將 EAX(double word) 轉為 EDX:EAX(quad word)
mov ecx, 100
idiv ecx ;eax/ecx => [intpu]^3 / 100 (商數存在 EAX,餘數存在 EDX)
mov ecx, eax ;暫時將商數放在 ECX
mov eax, quot_msg
call print_string
mov eax, ecx
call print_int ;印出商數
call print_nl
mov eax, rem_msg
call print_string
mov eax, edx ;印出餘數
call print_int
call print_nl

;轉換為負數(2補數)
neg edx
mov eax, neg_msg
call print_string
mov eax, edx
call print_int
call print_nl

popa
mov eax, 0 ;回到 C 程式
leave
ret

; 結果如下:
; Enter a number: 9
; Square of input is 81
; Cube of input is 729
; Cube of input times 25 is 18225
; Quotient of cube/100 is 7
; Remainder of cube/100 is 29
; The negation of the remainder is -29


更大數值的運算處理

雖然機會不多,可是並不表示不可能會有兩個 64 bits 數值的相加或相減,此時要怎麼作呢? 答案是使用 ADC 與 SBB 兩個指令。

以上那兩個指令都是使用 carry flag 來完成的,以下是他們的計算公式:
# ADC
operand1 = operand1 + carry flag + operand2

# SBB
operand1 = operand1 - carry flag - operand2

因此,假設有兩個 64 bits 的數值(EDX:EAX 與 EBX:ECX)要進行相加及相減的動作,可以用以下方式處理:
;相加
add eax, ecx ;lower 32 bits 相加
adc edx, ebx ;upper 32 bits 相加 + carry flag + 之前的計算結果

;相減
sub eax, ecx ;lower 32 bits 相減
sbb edx, ebx ;upper 32 bits 相減並根據 carry flag 決定是否借位

2008年2月7日 星期四

IA-32 Architecture (4/4)

要用那個 Segment Register ?

在 IA-32 架構中,一共有六個 segment register,而這幾個 segment register 又有個別不同的用途,使用上可以根據所要進行的操作來決定要用那個 register。

取得指令

當要讀取在記憶體中的指令時,CS register 便可提供指令所在的 segment base address,而 offset 部分則是由 IP(或是 EIP) register 所提供。

因此,指令所在的記憶體位址可以用下面的形式來表示:
CS:(E)IP

stack 的操作

當 CPU 進行 stack 的操作時(例如:push、pop),SS register 就會扮演 segment base address 的角色,而 offset 的部分則是 SP(或是 ESP) register。

存取資料

若存取記憶體是為了要讀寫資料的話,則預設由 DS 提供資料所在的 segment base address,而 offset 的部分則會根據定址模式的不同會有不同。


Input / Output

I/O 裝置相當多,不過大致可分為三種,分別是:
  1. input device
    這一類的裝置包含滑鼠、鍵盤.... 等等。
  2. output device
    這一類裝置包含螢幕、印表機 .... 等等。
  3. input/output device
    這一類裝置的代表則是磁碟機。

I/O 裝置與系統的溝通,都會被包含在 system bus 中;而為了減少因為眾多 I/O 連結至系統造成實作複雜、效能低落的情況發生,在 system bus 與 I/O 裝置之間加上了一個 I/O controller,以下用一張圖來說明:


因為若是讓 I/O 裝置直接與 system bus 銜接,CPU 就必須要了解並知道如何與 I/O 裝置進行溝通,因此效能肯定低落;透過 I/O controller,讓 I/O 裝置到 system bus 的訊號可以有一定的規範,CPU 就可以專心處理使用者的程式而非這些繁瑣的 I/O 工作。


一般在 I/O controller 中會有三個 register,分別是 data register、status register、command register。 若 CPU 要與 I/O 裝置進行溝通,就僅會跟相對應該裝置的 controller 進行溝通,而不是以直接的方式。

假設以送一個字元到印表機列印為例,會進行以下步驟:
  1. 一開始就會檢查 status register,確認印表機是開機或是關機、忙碌或是閒置、紙張是否用光 .... 等等
  2. 在 status register 中,bit 4 可用來判斷是否開機、bit 5 可用來判斷紙張是否用光、bit 7 可用來判斷是否忙碌 .... 等等
  3. data register 則是保存所要列印的資料,最後 command register 中則是包含 CPU 所要傳送至印表機的指令

而 CPU 是如何與 I/O controller 內部的 register 進行溝通呢? 答案是透過 I/O ports,而 I/O port 即為 I/O controller 內部 register 所在的位址。

接著說明 mapping I/O port 的方式,一共有兩種,分別是:
  1. memory-mapped I/O
    每個 I/O port 都會有其對應的記憶體位址。
  2. isolated I/O
    I/O address 空間與一般程式所使用的記憶體是分開的,自己獨立成為 I/O address space。在 IA-32 架構中提供了 64 KB 的空間作為 I/O address space 之用,可以用在 8-bit、16-bit、32-bit 的 I/O port 上,不論其使用方式,只要不超過 64 KB 的空間即可。

存取 I/O 裝置的方式

撰寫組合語言,可以直接透過 I/O controller 與 I/O 裝置進行歐通,但其實這樣是很辛苦的,因為有許多很 routine 的動作必須要完成(一般這是由 device driver 負責的),因此不但不方便而且也容易出錯,以磁碟裝置為例,若是沒寫好,說不定還會把資料全毀也不一定。

而為了避免這個情況發生,OS 通常都會提供 I/O 的標準存取方式;在 Linux 中稱為 system call,在 windows 中則稱為 interrupt。

IA-32 Architecture (3/4) - Real Mode Memory Architecture

在 real-mode 中,IA-32 的處理器就會使用 8086 的模式進行運作,其中差異最大的,當然就是僅有 20-bit address bus,定址空間僅有 1 MB(範圍介於 0x00000 ~ 0xFFFFF)。

由於 8086 系列的 CPU 中 register 的長度僅有 16 bits,如果僅用單一個 register 儲存記憶體位址,最大僅能表示到 64 KB(216 bytes),因此在 1 MB 的記憶體空間中,每一段大小都是 64 KB,並連續組合而成的。

而僅有 16-bit register 要如何表現 20-bit 長度的記憶體位址呢? 以下先用一張圖來表示:


左邊是可以透過 register 呈現出來的位址長度(僅有 16 bits),而右邊則是 20 bits 的定址長度,而問題在於如何將 16-bit 轉換為 20-bit 呢??

顯而易見的,每表示一個位址就必須要兩個 register 來作組合,其中一個作為 segment base,另一個則為 offset,以下用一張圖來說明:


接著說明位址轉換的步驟:
  1. 由於 register 僅有 16 bits 的關係,因此在 20 bits 的位址中,僅能表現前面的 16 bits,最後的 4 個 bit 則一律補 0,透過此方式來將 16-bit 轉換為 20-bit
  2. 接著加上另外一個 register 所儲存的 offset 值

透過以上這兩個步驟,就可以透過兩個 register 的方式來表示 20-bit 的記憶體位址。

【註】由於 register 僅有 16 bits 的關係,因此每個 segment 啟始位址的最後 2 個 bit 都一定是 0,例如:0x00000、0x00010、0x00020。


透過 segment 的方式,每個 memory address 都可以由 segment base 與 offset 的搭配來進行轉換而取得,一般會以「segment:offset」的形式來呈現,以上面的圖為例,1100:450H 就可以轉換為 0x11450(0x11000 + 0x0450)。

不過有一個地方是必須注意到的,每一組 logical address 都可以轉換為唯一的一組 physical address,但每一個 physical address 不一定可以轉換為為一一組 logical address,以下用圖舉個例子:

從圖中可以看出,原本兩個不同的 segment(0x1000 與 0x1200),但是加上不同的 offset(0x20A9 與 0xA9) 後,都產生出相同的 physical address(0x120A9)。

由於每個 segment 的大小不一定,因此擁有不同的 offset 也是會有可能的。

最後,在 real mode,每一個 segment 的基本大小就是 64 KB,若要轉換為更大的 physical memory segment,則必須仰賴 offset 的設定。

IA-32 Architecture (2/4) - Protected Mode Memory Architecture

簡介

在 IA-32 架構中,protected mode 是標準的記憶體架構,不但支援 segmentation,還支援 paging。

首先,memory address 的轉換是必須要知道的,以下先用一張圖來說明:


在 protected mode 支援了複雜的 segmentation 機制,其中 segment 單元會將 logical address 轉為 32-bit linear address,而 paging 單元會將 32-bit linear address 轉為 32-bit physical address。

若是沒有 paging 的機制,則 logical address 會直接轉換為 32-bit physical address。

接著以下用一張圖說明 segment 單元將 logical address 轉為 32-bit linear address 的過程:


在 segment register 中儲存的是 segment descriptor table 的索引值,用來取得相對應的 segment descriptor;而 segment descriptor 中則包含了 32-bit segment base address、size、存取權限 .... 等資訊

【註】descriptor table 包含了許多 segment descriptor,而每一個 segment descriptor 都有其 index 作為識別。

除了之外,為了將 logical address 轉為相對應的 linear address,還需要加入一個 offset 值,而 offset 則可以是 16-bit 或是 32-bit 的數值。


Segment Registers

每一個 segment register 都分為 visible 與 invisible 兩個部分,而我們一般提到的 segment register 都是指其 visible 的部分(長度為 16 bits),也其為 segment selector,以下用一張圖來說明:


其中 segment selector 共分為三個部分:
  1. Index
    使用 index 就可以取得在 local descriptor table(或是 global descriptor table) 中的 segment descriptor。
    根據上面的圖,可以看出 index 的長度為 13 bits,因此可以從 descriptor table 取得 8192(213) 個不同的 segment descriptor
  2. Table Indicator (TI)
    用來決定哪種 descriptor table 要被使用:
    0:global descriptor table
    1:local descriptor table
  3. Requester Privilege Level (RPL)
    設定資料的存取權限之用。數值越小,存取權限越大,例如:Linux kernel 使用 0,而一般程式使用 3。

Segment Descriptors

顧名思義,segment descriptor 所提供的是 segment 的相關屬性,包含了 32-bit base address、20-bit segment 長度、各種控制、狀態資訊 .... 等等,以下用一張圖來表示:


以下針對上圖的各欄位進行說明:

Base Address

由上圖三個紅色部分所組成的,長度為 32-bit,因此最大可以指向實體記憶體空間為 4GB 的 segment。
而若要轉為 linear address,就必須要加上 offset 值。

G(granularity bit)

用來指定 segment size 的單位。

有兩種情況:
  1. G = 0,則每單位為 1 byte
  2. G = 1,則每單位為 4KB。

Segment Limit

由上圖的兩個藍色部分所組成,長度為 20-bit,用來指定每個 segment 的大小,但須搭配上面的 G bit,因此會有兩種情形:
  1. G = 0,則可定址空間為 1 byte ~ 1 MB(220 x 1 byte)
  2. G = 1,則可定址空間為 4 KB ~ 4 GB(220 x 4KB)

D/B bit

若在 CS(code segment) 中,此 bit 稱為 D bit。會有以下兩種情形:
  1. D = 0,則運算元與 offset 長度預設為 16 bits
  2. D = 1,則運算元與 offset 長度預設為 32 bits。

若在 DS(data segment) 中,此 bit 稱為 B bit,作為控制 stack 的長度與 stack pointer 之用。會有以下兩種情形:
  1. B = 0,則 stack 相關的操作會使用 SP register,而 stack 空間上限為 0xFFFF
  2. B = 1,則 stack 相關的操作會使用 ESP register,而 stack 空間上限為 0xFFFFFFFF。

一般來說,在 protected mode 中,B = 1(set);若在 real mode 中,則 B = 0(clear)。

S bit

用來判斷 segment 屬於 system segment 或是 application segment。會有以下兩種情形:
  1. S = 0,則屬於 system segment
  2. S = 1,則屬於 application(code or data) segment。

DPL(Descriptor Privilege Level)

定義 segment 的權限等級。

Type

用來判斷 segment 的類型。

以 application segment 為例,分為 code segment 與 data segment。

假設是 data segment(儲存資料的記憶體位址),Type 可以將其定義為 read-only、read-write .... 等等不同類型;若是 code segment(儲存指令的記憶體位址),則 Type 可以定義為 execute-only、execute/read-only .... 等等不同類型。

P bit

用來判斷是否此 segment 是存在的的。

假設 P = 1,當有 segment selector 讀進此 segment register 時,CPU 會產生 segment-not-present 的例外。


Segment Descriptor Table

segment descriptor table 即為儲存 segment descriptor 的陣列,其中的每個 segment descriptor 都有所屬的特定 index。

而 descriptor table 一共可以分為以下三種類型:
  1. GDT(Global Descriptor Table)
  2. LDT(Local Descriptor Table)
  3. IDT(Interrupt Descriptor Table)

每個 descriptor table 的大小介於 8 bytes ~ 64 KB 之間。

其中 IDT(Interrupt Descriptor Table) 是作為中斷處理之用;而 GDT(Global Descriptor Table) 與 LDT(Local Descriptor Table) 最多可以包含 213 = 8192 個長度為 8 bits 的 segment descriptor。

另外,每個 descriptor table 都有一個相對應的 register,而這個 register 作用是在於儲存 32-bit 的 linear base address 與 16-bit 的 descriptor table 大小,分別是:
  • GDT => GDTR
  • LDT => LDTR

這兩個 register 有指令可以使用他們(load => lgdt、lldt,store => sgdt、sldt),不過通常這個部分都是由 OS 來作。

最後描述一下 GDT 與 LDT 的差異所在:
  • GDT(Global Descriptor Table)
    數量只有一個,所有在系統中的 task 都可以使用此 table 中的 descriptor,通常 GDT 中所包含的都是給 OS 所用的 code 及 data。
  • LDT(Local Descriptor Table)
    數量可以有多個,每個 LDT 中所包含的 descriptor 都是屬於某支程式,而有些 LDT 的 descriptor 可能包含 code、data、stack .... 等等。


Segmentation Models

在 IA-32 架構下,單一 segment 最大可以擴展到 4GB。若是將 segment base address 設定為 0,並設定其 size 為 4 GB,就可以達成 segment 的大小為 4 GB 的目的,而這種作法在 UNIX 或 Linux 都見的到,稱為 flat model。

另外還有一種稱為 multisegment model,以下先用一張圖來表示:


一般的程式可能會使用超過 6 個 segment,在正常的情況下,相關的 segment 資訊都會讀入 segment descriptor 中(超過 6 個),但每一次可用的僅有 6 個 segment(因為僅有 6 個 segment register),若要啟用尚未使用的 segment,只要將指向 segment 的 selector 讀入 segment register,CPU 就可以從相對應的 descriptor table 中存取該 segment。