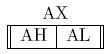2008年2月8日 星期五

PC Assembly Language 學習筆記(4) - Working with Integer

整數表示法

在電腦系統中,根據有無正負號,分為 unsigned 與 signed;在 unsigned 的部分就不需太多討論了,因為就很直覺的進行換算即可,而 signed 的部分,在電腦系統中是使用 2 補數的方式來表示。

2 補數的換算很簡單,只要先換成 1 補數(0 1 對調),再加上 1 即為 2 補數;使用 2 補數除了有表示範圍較大之外,CPU 也較容易處理;而在 assembly 中若是要計算 2 補數,可以用 NEG 這個指令,可以直接將指定的運算子轉換為 2 補數(運算元可以是 register 或是 memory address)。

另外,對 CPU 來說,並不知道要資料的長度為何(完全不知道所處理的是 byte、word、還是 double word),因此程式設計師若要指定處理資料的大小,就必須仰賴所使用的指令。


signed extension

在 assembly 中,所有的資料都會有其大小,根據程式需求改變資料程度是很平常的事情,以下給的例子:
;AX = 0x134(長度為 16 bits)
;AX = 308
mov ax, 0134H
;將 AX register 中的 lower 8 bits 放入 CL register 中
;CL = 0x34(長度為 8 bits)
;CL = 52
mov cl, al
從上面例子可看出,由於資料大小改變了,因此其值也改變了。

另外,若要加大資料的長度可就不是這麼簡單了,舉個例子來說,假設有一個值為 0xFF,要從原本的 8 bits 轉為 16 bits,若是 unsigned integer 倒也是簡單,但若是 signed integer,那可就不是隨便前面補 0 就可以完成的了!

在 80386 系列的 CPU,提供了多個指令可以進行擴充資料長度這一類的工作,以下用範例來說明:
;以下指令僅用於 unsigned integer
;destination 的長度必須大於 source
movzx eax, ax ;複製 AX 的內容到 EAX (16 bits -> 32 bits)
movzx eax, al ;複製 AL 的內容到 EAX (8 bits -> 32 bits)
movzx ax, al ;複製 AL 的內容到 AX (8 bits -> 16 bits)
movzx ebx, ax ;複製 AX 的內容到 RBX (16 bits -> 32 bits)
如註解上說明,movzx 指令僅能用於 unsigned integer,而若是要擴充 signed integer 的長度,在 8086 下可使用以下指令:(此時僅有 16-bit register)
  • CBW(Convert Byte to Word)
    將 AL register 中的資料加以擴充轉換後,存入 AX register 中
  • CWD(Convert Word to Double word)
    將 AX register 中的資料加以擴充轉換後,分成兩組存入 DX 與 AX register 中,變成 DX:AX (32 bits)

若在 80386 以後,則提供了以下指令:
  • CWDE(Convert Word to Double word extended)
    將 AX register 中的資料加以擴充轉換後,存入 EAX register 中
  • CDQ(Convert Double word to Quad word)
    將 EAX register 中的資料加以擴充轉換後,分成兩組存入 EDX 與 EAX register 中,變成 EDX:EAX (64 bits)

此外還多提供了 MOVSX 的指令,用法語 MOVZX 相同,但可以用來搬移 signed integer。


與 C 語言的對照

上面說了一堆 unsigned/signed,在 C 語言中又是如何呢? 以下用程式來說明:

在 C 語言中,char 為 1 byte,而 int 為 4 bytes;以上程式轉為 assembly 應該是怎麼作呢?

unsigned char -> integer,使用 MOVZX (此指令用於 unsigned integer)

signed char -> integer:使用 MOVSX (此指令用於 signed integer)


然而有沒有指定 unsigned 或是 signed 真的很重要嗎? 以下用另外一段程式來說明:

仔細看 while 執行的條件,必須判斷 char 並非 EOF(-1) 才會繼續執行。

而 char 要與 integer 作比較,就必需要經過 extend 的動作;然而,若是遇到 EOF 字元為 0xFF,在 unsigned/signed 兩種不同情況下,會擴充為:
  • unsigned => 0x000000FF
  • signed => 0xFFFFFFFF (因為 signed char 0xFF 為 -1)

若是 unsigned 的情況下,原本的 EOF char 會被轉為 255 而非 -1,如此一來結果就不對了! 所以,C 語言中預設變數都是 signed 原因即是如此。


2 補數的四則運算

加法(addition)、減法(subtraction)

2 補數有一個很大的優點,就是不論 unsigned 或是 signed,進行加法(ADD)或減法(SUB)的方式都是相同的。

但在進行加減法運算時,會影響到 EFLAGS register 中的兩個 bit,分別是 overflow 以及 carry,以下說明一下相關情況:
  1. 針對 signed 數值運算,若 destination 空間不夠存放計算出來的結果,則 overflow=1,反之則為 0
  2. 若計算中產生借位或溢位的情況,則 carry=1,反之為 0

以下用一個算式說明 carry 的發生:


乘法(multiply)

為了處理 unsigned 以及 signed 的問題,乘法的部分有兩種指令,分別是 MUL(用於 unsigned) 與 IMUL(用於 signed)。

MUL 的用法如下:
mul source
結果會有三種,分別是:(source 也可以是相同大小的 memory 位址)
  1. source 為 AL(8 bits) 中的值,則結果會存在 AX(16 bits) register 中
  2. source 為 AX(16 bits) 中的值,則結果會存在 DX:AX(32 bits) 中
  3. 若 source 為 EAX(32 bits),則結果會存在 EDX:EAX(64 bits) 中。

而 IMUL 就是負責處理 signed 的部分,IMUL 的用法有以下幾種:
imul source1
imul dest, source1
imul dest, source1, source2
這樣一來使用組合就有很多種了,以下用一張圖來說明:


除法(devide)

除法與乘法是差不多的,針對 unsigned 與 signed 也都有兩種不同的指令,分別是 DIV(用於 unsigned) 與 IDIV(用於 signed)。

而除法的部分就牽涉到商數(quotient)和餘數(remainder)的部分,不過最重要的則是除數(source),以下說明一下除法的規則:
  1. source(除數) 為 8 bits,則要將被除數存放在 AX 中,最後 quotient 存於 AL 中,remainder 存於 AH 中
  2. source(除數) 為 16 bits,則要將被除數分成兩個部分存放在 DX:AX 中,最後 quotient 存於 AX 中,remainder 存於 DX 中
  3. source(除數) 為 32 bits,則要將被除數分成兩個部分存放在 EDX:EAX 中,最後 quotient 存於 EAX 中,remainder 存於 EDX 中

而 IDIV 的用法跟 DIV 是相同的,不像 IMUL 有另外不同的用法。


四則運算說明完後,當然要來個範例囉! 以下有個簡單的範例程式:
;檔案: math.asm
;描述:四則運算練習

%include "asm_io.inc"

;初始化資料
segment .data
prompt db "Enter a number: ", 0
square_msg db "Square of input is ", 0
cube_msg db "Cube of input is ", 0
cube25_msg db "Cube of input times 25 is ", 0
quot_msg db "Quotient of cube/100 is ", 0
rem_msg db "Remainder of cube/100 is ", 0
neg_msg db "The negation of the remainder is ", 0

;未初始化資料
segment .bss
input resd 1

segment .text
global asm_main
asm_main:
enter 0, 0 ;程式開始
pusha

;顯示提示訊息
mov eax, prompt
call print_string

;讀取使用者輸入的整數
call read_int
mov [input], eax

imul eax ;edx:eax = eax * eax
mov ebx, eax ;將相乘後的結果暫時存放於 EBX 中

;顯示[intput]^2的結果
mov eax, square_msg
call print_string
mov eax, ebx
call print_int
call print_nl

;顯示[intput]^3的結果
mov ebx, eax
imul ebx, [input] ;ebx *= [input]
mov eax, cube_msg
call print_string
mov eax, ebx
call print_int
call print_nl

;顯示[intput]^3 * 25的結果
imul ecx, ebx, 25
mov eax, cube25_msg
call print_string
mov eax, ecx
call print_int
call print_nl


mov eax, ebx
cdq ;將 EAX(double word) 轉為 EDX:EAX(quad word)
mov ecx, 100
idiv ecx ;eax/ecx => [intpu]^3 / 100 (商數存在 EAX,餘數存在 EDX)
mov ecx, eax ;暫時將商數放在 ECX
mov eax, quot_msg
call print_string
mov eax, ecx
call print_int ;印出商數
call print_nl
mov eax, rem_msg
call print_string
mov eax, edx ;印出餘數
call print_int
call print_nl

;轉換為負數(2補數)
neg edx
mov eax, neg_msg
call print_string
mov eax, edx
call print_int
call print_nl

popa
mov eax, 0 ;回到 C 程式
leave
ret

; 結果如下:
; Enter a number: 9
; Square of input is 81
; Cube of input is 729
; Cube of input times 25 is 18225
; Quotient of cube/100 is 7
; Remainder of cube/100 is 29
; The negation of the remainder is -29


更大數值的運算處理

雖然機會不多,可是並不表示不可能會有兩個 64 bits 數值的相加或相減,此時要怎麼作呢? 答案是使用 ADC 與 SBB 兩個指令。

以上那兩個指令都是使用 carry flag 來完成的,以下是他們的計算公式:
# ADC
operand1 = operand1 + carry flag + operand2

# SBB
operand1 = operand1 - carry flag - operand2

因此,假設有兩個 64 bits 的數值(EDX:EAX 與 EBX:ECX)要進行相加及相減的動作,可以用以下方式處理:
;相加
add eax, ecx ;lower 32 bits 相加
adc edx, ebx ;upper 32 bits 相加 + carry flag + 之前的計算結果

;相減
sub eax, ecx ;lower 32 bits 相減
sbb edx, ebx ;upper 32 bits 相減並根據 carry flag 決定是否借位

2008年2月7日 星期四

IA-32 Architecture (4/4)

要用那個 Segment Register ?

在 IA-32 架構中,一共有六個 segment register,而這幾個 segment register 又有個別不同的用途,使用上可以根據所要進行的操作來決定要用那個 register。

取得指令

當要讀取在記憶體中的指令時,CS register 便可提供指令所在的 segment base address,而 offset 部分則是由 IP(或是 EIP) register 所提供。

因此,指令所在的記憶體位址可以用下面的形式來表示:
CS:(E)IP

stack 的操作

當 CPU 進行 stack 的操作時(例如:push、pop),SS register 就會扮演 segment base address 的角色,而 offset 的部分則是 SP(或是 ESP) register。

存取資料

若存取記憶體是為了要讀寫資料的話,則預設由 DS 提供資料所在的 segment base address,而 offset 的部分則會根據定址模式的不同會有不同。


Input / Output

I/O 裝置相當多,不過大致可分為三種,分別是:
  1. input device
    這一類的裝置包含滑鼠、鍵盤.... 等等。
  2. output device
    這一類裝置包含螢幕、印表機 .... 等等。
  3. input/output device
    這一類裝置的代表則是磁碟機。

I/O 裝置與系統的溝通,都會被包含在 system bus 中;而為了減少因為眾多 I/O 連結至系統造成實作複雜、效能低落的情況發生,在 system bus 與 I/O 裝置之間加上了一個 I/O controller,以下用一張圖來說明:


因為若是讓 I/O 裝置直接與 system bus 銜接,CPU 就必須要了解並知道如何與 I/O 裝置進行溝通,因此效能肯定低落;透過 I/O controller,讓 I/O 裝置到 system bus 的訊號可以有一定的規範,CPU 就可以專心處理使用者的程式而非這些繁瑣的 I/O 工作。


一般在 I/O controller 中會有三個 register,分別是 data register、status register、command register。 若 CPU 要與 I/O 裝置進行溝通,就僅會跟相對應該裝置的 controller 進行溝通,而不是以直接的方式。

假設以送一個字元到印表機列印為例,會進行以下步驟:
  1. 一開始就會檢查 status register,確認印表機是開機或是關機、忙碌或是閒置、紙張是否用光 .... 等等
  2. 在 status register 中,bit 4 可用來判斷是否開機、bit 5 可用來判斷紙張是否用光、bit 7 可用來判斷是否忙碌 .... 等等
  3. data register 則是保存所要列印的資料,最後 command register 中則是包含 CPU 所要傳送至印表機的指令

而 CPU 是如何與 I/O controller 內部的 register 進行溝通呢? 答案是透過 I/O ports,而 I/O port 即為 I/O controller 內部 register 所在的位址。

接著說明 mapping I/O port 的方式,一共有兩種,分別是:
  1. memory-mapped I/O
    每個 I/O port 都會有其對應的記憶體位址。
  2. isolated I/O
    I/O address 空間與一般程式所使用的記憶體是分開的,自己獨立成為 I/O address space。在 IA-32 架構中提供了 64 KB 的空間作為 I/O address space 之用,可以用在 8-bit、16-bit、32-bit 的 I/O port 上,不論其使用方式,只要不超過 64 KB 的空間即可。

存取 I/O 裝置的方式

撰寫組合語言,可以直接透過 I/O controller 與 I/O 裝置進行歐通,但其實這樣是很辛苦的,因為有許多很 routine 的動作必須要完成(一般這是由 device driver 負責的),因此不但不方便而且也容易出錯,以磁碟裝置為例,若是沒寫好,說不定還會把資料全毀也不一定。

而為了避免這個情況發生,OS 通常都會提供 I/O 的標準存取方式;在 Linux 中稱為 system call,在 windows 中則稱為 interrupt。

IA-32 Architecture (3/4) - Real Mode Memory Architecture

在 real-mode 中,IA-32 的處理器就會使用 8086 的模式進行運作,其中差異最大的,當然就是僅有 20-bit address bus,定址空間僅有 1 MB(範圍介於 0x00000 ~ 0xFFFFF)。

由於 8086 系列的 CPU 中 register 的長度僅有 16 bits,如果僅用單一個 register 儲存記憶體位址,最大僅能表示到 64 KB(216 bytes),因此在 1 MB 的記憶體空間中,每一段大小都是 64 KB,並連續組合而成的。

而僅有 16-bit register 要如何表現 20-bit 長度的記憶體位址呢? 以下先用一張圖來表示:


左邊是可以透過 register 呈現出來的位址長度(僅有 16 bits),而右邊則是 20 bits 的定址長度,而問題在於如何將 16-bit 轉換為 20-bit 呢??

顯而易見的,每表示一個位址就必須要兩個 register 來作組合,其中一個作為 segment base,另一個則為 offset,以下用一張圖來說明:


接著說明位址轉換的步驟:
  1. 由於 register 僅有 16 bits 的關係,因此在 20 bits 的位址中,僅能表現前面的 16 bits,最後的 4 個 bit 則一律補 0,透過此方式來將 16-bit 轉換為 20-bit
  2. 接著加上另外一個 register 所儲存的 offset 值

透過以上這兩個步驟,就可以透過兩個 register 的方式來表示 20-bit 的記憶體位址。

【註】由於 register 僅有 16 bits 的關係,因此每個 segment 啟始位址的最後 2 個 bit 都一定是 0,例如:0x00000、0x00010、0x00020。


透過 segment 的方式,每個 memory address 都可以由 segment base 與 offset 的搭配來進行轉換而取得,一般會以「segment:offset」的形式來呈現,以上面的圖為例,1100:450H 就可以轉換為 0x11450(0x11000 + 0x0450)。

不過有一個地方是必須注意到的,每一組 logical address 都可以轉換為唯一的一組 physical address,但每一個 physical address 不一定可以轉換為為一一組 logical address,以下用圖舉個例子:

從圖中可以看出,原本兩個不同的 segment(0x1000 與 0x1200),但是加上不同的 offset(0x20A9 與 0xA9) 後,都產生出相同的 physical address(0x120A9)。

由於每個 segment 的大小不一定,因此擁有不同的 offset 也是會有可能的。

最後,在 real mode,每一個 segment 的基本大小就是 64 KB,若要轉換為更大的 physical memory segment,則必須仰賴 offset 的設定。

IA-32 Architecture (2/4) - Protected Mode Memory Architecture

簡介

在 IA-32 架構中,protected mode 是標準的記憶體架構,不但支援 segmentation,還支援 paging。

首先,memory address 的轉換是必須要知道的,以下先用一張圖來說明:


在 protected mode 支援了複雜的 segmentation 機制,其中 segment 單元會將 logical address 轉為 32-bit linear address,而 paging 單元會將 32-bit linear address 轉為 32-bit physical address。

若是沒有 paging 的機制,則 logical address 會直接轉換為 32-bit physical address。

接著以下用一張圖說明 segment 單元將 logical address 轉為 32-bit linear address 的過程:


在 segment register 中儲存的是 segment descriptor table 的索引值,用來取得相對應的 segment descriptor;而 segment descriptor 中則包含了 32-bit segment base address、size、存取權限 .... 等資訊

【註】descriptor table 包含了許多 segment descriptor,而每一個 segment descriptor 都有其 index 作為識別。

除了之外,為了將 logical address 轉為相對應的 linear address,還需要加入一個 offset 值,而 offset 則可以是 16-bit 或是 32-bit 的數值。


Segment Registers

每一個 segment register 都分為 visible 與 invisible 兩個部分,而我們一般提到的 segment register 都是指其 visible 的部分(長度為 16 bits),也其為 segment selector,以下用一張圖來說明:


其中 segment selector 共分為三個部分:
  1. Index
    使用 index 就可以取得在 local descriptor table(或是 global descriptor table) 中的 segment descriptor。
    根據上面的圖,可以看出 index 的長度為 13 bits,因此可以從 descriptor table 取得 8192(213) 個不同的 segment descriptor
  2. Table Indicator (TI)
    用來決定哪種 descriptor table 要被使用:
    0:global descriptor table
    1:local descriptor table
  3. Requester Privilege Level (RPL)
    設定資料的存取權限之用。數值越小,存取權限越大,例如:Linux kernel 使用 0,而一般程式使用 3。

Segment Descriptors

顧名思義,segment descriptor 所提供的是 segment 的相關屬性,包含了 32-bit base address、20-bit segment 長度、各種控制、狀態資訊 .... 等等,以下用一張圖來表示:


以下針對上圖的各欄位進行說明:

Base Address

由上圖三個紅色部分所組成的,長度為 32-bit,因此最大可以指向實體記憶體空間為 4GB 的 segment。
而若要轉為 linear address,就必須要加上 offset 值。

G(granularity bit)

用來指定 segment size 的單位。

有兩種情況:
  1. G = 0,則每單位為 1 byte
  2. G = 1,則每單位為 4KB。

Segment Limit

由上圖的兩個藍色部分所組成,長度為 20-bit,用來指定每個 segment 的大小,但須搭配上面的 G bit,因此會有兩種情形:
  1. G = 0,則可定址空間為 1 byte ~ 1 MB(220 x 1 byte)
  2. G = 1,則可定址空間為 4 KB ~ 4 GB(220 x 4KB)

D/B bit

若在 CS(code segment) 中,此 bit 稱為 D bit。會有以下兩種情形:
  1. D = 0,則運算元與 offset 長度預設為 16 bits
  2. D = 1,則運算元與 offset 長度預設為 32 bits。

若在 DS(data segment) 中,此 bit 稱為 B bit,作為控制 stack 的長度與 stack pointer 之用。會有以下兩種情形:
  1. B = 0,則 stack 相關的操作會使用 SP register,而 stack 空間上限為 0xFFFF
  2. B = 1,則 stack 相關的操作會使用 ESP register,而 stack 空間上限為 0xFFFFFFFF。

一般來說,在 protected mode 中,B = 1(set);若在 real mode 中,則 B = 0(clear)。

S bit

用來判斷 segment 屬於 system segment 或是 application segment。會有以下兩種情形:
  1. S = 0,則屬於 system segment
  2. S = 1,則屬於 application(code or data) segment。

DPL(Descriptor Privilege Level)

定義 segment 的權限等級。

Type

用來判斷 segment 的類型。

以 application segment 為例,分為 code segment 與 data segment。

假設是 data segment(儲存資料的記憶體位址),Type 可以將其定義為 read-only、read-write .... 等等不同類型;若是 code segment(儲存指令的記憶體位址),則 Type 可以定義為 execute-only、execute/read-only .... 等等不同類型。

P bit

用來判斷是否此 segment 是存在的的。

假設 P = 1,當有 segment selector 讀進此 segment register 時,CPU 會產生 segment-not-present 的例外。


Segment Descriptor Table

segment descriptor table 即為儲存 segment descriptor 的陣列,其中的每個 segment descriptor 都有所屬的特定 index。

而 descriptor table 一共可以分為以下三種類型:
  1. GDT(Global Descriptor Table)
  2. LDT(Local Descriptor Table)
  3. IDT(Interrupt Descriptor Table)

每個 descriptor table 的大小介於 8 bytes ~ 64 KB 之間。

其中 IDT(Interrupt Descriptor Table) 是作為中斷處理之用;而 GDT(Global Descriptor Table) 與 LDT(Local Descriptor Table) 最多可以包含 213 = 8192 個長度為 8 bits 的 segment descriptor。

另外,每個 descriptor table 都有一個相對應的 register,而這個 register 作用是在於儲存 32-bit 的 linear base address 與 16-bit 的 descriptor table 大小,分別是:
  • GDT => GDTR
  • LDT => LDTR

這兩個 register 有指令可以使用他們(load => lgdt、lldt,store => sgdt、sldt),不過通常這個部分都是由 OS 來作。

最後描述一下 GDT 與 LDT 的差異所在:
  • GDT(Global Descriptor Table)
    數量只有一個,所有在系統中的 task 都可以使用此 table 中的 descriptor,通常 GDT 中所包含的都是給 OS 所用的 code 及 data。
  • LDT(Local Descriptor Table)
    數量可以有多個,每個 LDT 中所包含的 descriptor 都是屬於某支程式,而有些 LDT 的 descriptor 可能包含 code、data、stack .... 等等。


Segmentation Models

在 IA-32 架構下,單一 segment 最大可以擴展到 4GB。若是將 segment base address 設定為 0,並設定其 size 為 4 GB,就可以達成 segment 的大小為 4 GB 的目的,而這種作法在 UNIX 或 Linux 都見的到,稱為 flat model。

另外還有一種稱為 multisegment model,以下先用一張圖來表示:


一般的程式可能會使用超過 6 個 segment,在正常的情況下,相關的 segment 資訊都會讀入 segment descriptor 中(超過 6 個),但每一次可用的僅有 6 個 segment(因為僅有 6 個 segment register),若要啟用尚未使用的 segment,只要將指向 segment 的 selector 讀入 segment register,CPU 就可以從相對應的 descriptor table 中存取該 segment。

2008年2月5日 星期二

IA-32 Architecture (1/4)

簡介

若要撰寫 assembly,就必須要了解處理器的架構,目前最常見的事 IA(Intel Architecture)-32 架構,市面上的 Pentium、Celeron、Xeon .... 等等 CPU 都是屬於 IA-32 架構,並支援兩種不同的記憶體架構,分別為 real mode 與 protected mode。

關於 80x86 處理器的演化過程以及每個階段所加入的改變,可以參考 小木偶的網頁 - 組合語言準備工作 一文得到詳細的說明。


Processor Execution Cycle

CPU 的執行週期大概可以分為三個階段:
  1. Fetch:從記憶體中取得指令
    放置正確的位址到 address bus 上,並在 control bus 上輸入 memory read 訊號讓指令可以在正確的記憶體中被取出。
  2. Decode:將指令解碼
    此階段必須辨識從記憶體中取出的指令為何,並進行解碼的動作,這裡有相對應的 schema 可以將其轉為 machine language。
  3. Execute:執行指令
    執行指令時,CPU 中的控制電路會負責時間的控制,而 ALU(Arithmetic & Logic Unit) 則會負責針對資料進行數學及邏輯相關運算處理。

這三個階段通常被稱為 fetch-decode-execute cycle(或是 execution cycle),以下用一張簡單的圖來說明:

其實 Execution Cycle 通常不是在主記憶體中完成,而是在 cache 中,因為 cache 的速度比記憶體更快,不過由於這一段(CPU <-> cache <-> memory)是透明的,因此撰寫應用程式時不需要考量到這個。


Process Registers

在 IA-32 架構中,提供了 10 個 32-bit 以及 6 個 16-bit 的 register,根據用途不同可分為 general、control、segment .... 等幾種;其中 general 還細分為 data、pointer、index 三種 register。

以下針對不同的 register 進行說明:

Data Registers

首先先用一張圖說明 data register 的組成:


這 4 個 32-bit 的 data register 可以用在數學、邏輯、或是其他不同的處理。且看其結構,可以知道為了與上一代的 CPU 相容的設計:
  1. 4 個 32-bit register:EAX、EBX、ECX、EDX
  2. 8 個 16-bit register:AX、BX、CX、DX
  3. 8 個 8-bit register:AH、AL、BH、BL、CH、CL、DH、DL

每一個 register 都是獨立的,因此可以根據需求決定使用 8-bit、16-bit、或是 32-bit 的 register。

但存取時就必須注意一下,假設要讀取 EAX 中的 lower 16 bits 的資料,可以直接存取 AX,會得到相同的效果(因為 AX 本來就是 EAX lower 16 bit 的部分);若是要存取 AX 中 higher 8 bit 的資料,則可以直接存取 AH(因為 AH 為 AX 的 higher 8 bit)。

一般來說,這幾個 register 進行任何數學、邏輯處理都不會有問題,但還是有特例,例如:進行乘法時必須用到 EAX(或是 AX、或是 AL) register;進行迴圈處理時,ECX(或 CX) 則是儲存迴圈執行次數的 register;這些特例都是必須要注意的。

Pointer & Index Registers

首先用一張圖說明 pointer & index register 的組成:


首先,這兩種 register 與 data register 類似,也是 32-bit 與 16-bit 的組合,使用上就端看所處理的資料長度來進行不同的運用。

index register 通常用於字串處理的指令上,除此之外,可以當作一般的 data register 使用。

pointer register 則是專門負責管理 stack 狀態(其實也可以將其當作 data register 使用,不過還是多用於 stack 上)。

Control Registers

control register 有兩個,分別是 flags register 以及 instruction register,以下用一張圖來表示:


instruction pointer register(有時稱為 program counter register) 的作用在於儲存下一個準備被執行的指令所在的記憶體位址之用,當指令從記憶體中被取出後,instruction pointer register 的內容則會更新為下一個準備執行的指令所在的記憶體位址。

另外若是使用傳送 jump、procedure call、interrupt 等控制訊號,亦會更改 instruction pointer register 的內容。

使用上若是需要 32-bit 長度,可使用 EIP;若是 16-bit 則使用 IP。

flags register 也是相同,包含 32-bit 及 16-bit;以 EFLAGS(32-bit) 來說,包含了 6 個 status flag、1 個 control flag、10 個 system flag(詳細名稱可以參考上圖),而 EFLAGS 中的每個 bit 都是獨立有其意義的,可以是 1(set) 或 0(clear),可以用指令修改,例如:clc 指令可設定 carry flag 為 0,stc 指令則可設定 carry flag 為 1。

但 flag register 通常是用來記錄運算、邏輯處理的狀態之用,以下舉幾個例子來說明:
  1. 進行減法時結果為 0,ZF(zero flag) 會設定為 1
  2. 處理字串時,可以使用 DF(direction flag) 來決定掃瞄字串的方向(forward or backward)
  3. 將 TF(trap falg) 設定為 1,可以讓 CPU 以一行一行的方式執行程式,對於 debug 會有相當幫助
  4. ID(identification flag) 則是用來決定是否支援 CPUID 這個指令

Segment Registers

最後 6 個 16-bit register 就是 segment register,以下用一張圖來說明 segment register 的組成:


在 IA-32 架構下,記憶體會被分為數個 segment,每個 segment 是一小部分的記憶體空間,而 segment register 中儲存的則是指向這些記憶體空間的位址。

但由於只有 6 個 segment register,因此 CPU 最多同一時間僅能存取六個不同的 memory segment。

另外,程式在邏輯上分為兩個部分,分別是 code 與 data;其中 code 的部分所存的僅有指令,而 data 的部分則是僅有程式所需要的資料。

而 CS(code segment) 中所儲存的正是 code 所在的記憶體位址,而 DS(data segment) 儲存的則是 data 所在的記憶體位址,另外,SS(stack segment) 中儲存的則是指向程式的 stack segment 的記憶體位址。

另外三個 ES、FS、GS,則是額外的 segment register,可以作為類似其他的 segment register 使用,例如:當一個 DS 不足以儲存程式所使用資料的記憶體位址,則可能會借用這三個額外 segment register 來使用。

2008年1月27日 星期日

PC Assembly Language 學習筆記(3) - Creating a Program

前言

其實,直接以 assembly 開發所有程式是很不容易的,應該也很少人會這麼做;不過,了解 assembly 還是有好處的,像是:
  1. 一般寫的 assembly code 會比由 compiler 所產生的更小更快
  2. assembly 可以直接存取硬體,一般來說這是高階語言不允許的
  3. 學習如何寫 assembly 有助於更深入了解電腦是如何運作的
  4. 學習如何寫 assembly 可以更了解 compiler 與高階語言是如何運作的


第一支 NASM 程式

之後的程式,將會以 C 語言為起點,中間進入 assembly code,最後再回到 C 以結束程式。

這樣做的好處有以下兩點:
  1. 讓 C 確保程式可以正確的在 protected mode 中運作,所有的 segment 與對應的 segment register 都交由 C 負責初始化,寫 assembly code 時完全不用擔心這個部分。
  2. 可以在 assembly code 中使用 C standard library

首先,先說明所使用的 C 程式,程式如下:
int main() {
int ret_status;
ret_status = asm_main();

return ret_status;
}
再來是 assembly code:
;檔案: first.asm
;描述:第一支 NASM 程式
;目的:詢問兩個整數,並印出兩個整數之和
;
;建立執行檔的語法如下:(in Ubuntu Linux)
; nasm -f elf first.asm
; gcc -o first first.o driver.c asm_io.o

%include "asm_io.inc"

;初始化資料置於 .data segment
segment .data
; 這些 label 指向儲存顯示用字串的記憶體位址
prompt1 db "Enter a number : ", 0 ;記得要加 null terminator(\0)
prompt2 db "Enter another number : ", 0
outmsg1 db "You entered ", 0
outmsg2 db " and ", 0
outmsg3 db ", the sum of these is ", 0

;未初始化的資料置於 .bss(block started by symbol) segment
segment .bss
;這些 label 指向儲存輸入的 double words 記憶體位址
input1 resd 1 ;指定一個未初始化的 double word 空間
input2 resd 1

;程式碼置於 .text segment
segment .text
global asm_main
asm_main:
enter 0, 0 ;程式開始
pusha

mov eax, prompt1 ;將 Label "prompt1" 的 memory address 置於 EAX register 中
call print_string ;作者提供的 library,可印出 EAX register 所指向的字串

call read_int ;作者提供的 library,可讀取使用者輸入的 integer,並存到 EAX register 中
mov [input1], eax ;將 EAX register 中的 interger 存入 Label "input1"

mov eax, prompt2 ;輸出 prompt2 字串
call print_string

call read_int ;讀取使用者輸入的 interger 並置於 Label "input2"
mov [input2], eax

mov eax, [input1] ;將輸入的兩個 integer 相加,並將結果置於 EBX register 中
add eax, [input2]
mov ebx, eax

dump_regs 1 ;將 register 的內容印出
dump_mem 2, outmsg1, 1 ;將 memory 的內容印出


mov eax, outmsg1 ;輸出 outmsg1 (string)
call print_string
mov eax, [input1] ;輸出 input1 (integer)
call print_int
mov eax, outmsg2 ;輸出 outmsg2 (string)
call print_string
mov eax, [input2] ;輸出 input2 (integer)
call print_int
mov eax, outmsg3 ;輸出 outmsg3 (string)
call print_string
mov eax, ebx ;輸出加總後的結果 (integer)
call print_int
call print_nl ;輸出 new line

popa
mov eax, 0 ; 回到 C 程式
leave
ret
在開發程式中,有幾點是必須注意的:
  1. 預先初始化的資料要擺在 .data segment 中 (預先定義好的字串)
  2. 未初始化的資料要擺在 .bss(block started by symbol) segment 中 (儲存使用者輸入的變數)
  3. 程式碼的部分則則是擺在 .text segment 中
  4. 若是在 DOS/Windows 的環境下,asm_main 的前方必須加上底線(_)變成 _asm_main,稱為 C calling convention (但在 Linux 的環境下則不用)
  5. 程式中指定了 asm_main 為 global,表示同一個模組中的程式碼都可以存取 asm_main (在 asm_io 模組中定義的 print_int 也是 global,因此才可以在程式中使用)


編譯與執行

程式開發完成後,當然要進行編譯與執行了,有以下步驟要分別進行:
  1. 組譯 assembly code
    # 使用 ELF(Executable and Linkable Format) 格式 (GNU C Compiler)
    # 若使用 DJGPP,則格式要改為 COFF(Common Object File Format)
    # 若使用 Borland compiler,則格式為 OBJ

    shell> nasm -f elf first.asm

    # 若是使用 -l 參數可以產生 listing file,檔案中描述程式碼是如何被組譯的
    shell> nasm -f elf -l first.list first.asm
  2. 編譯 C code
    # 僅編譯,不進行 link
    shell> gcc -c driver.c
  3. link 所有 object file
    # first 為執行檔名稱
    shell> gcc -o first driver.o first.o asm_io.o

    # 或是省略第二個步驟,直接進行 compile 與 link
    shell> gcc -o first driver.c first.o asm_io.o


Big & Little Endian Representation

不同的 CPU 中,資料表示的方法是有差別的,以 double word 大小(4 bytes)儲存十進位 20 為例,兩種表示法如下:
  • Big Endian (最大的 byte 擺在最前面):00 00 00 14
  • Little Endian (最小的 byte 擺在最前面):14 00 00 00

使用 big endian 大多為 RISC 的處理器,或是 Motorola 的處理器;而一般我們電腦用的 Intel-based CPU,則是使用 little endian;因此這是必須要注意的。

而這個部分,大概只有以下情況需要注意:
  1. 在不同的電腦中傳遞二進位資料時(可能透過檔案或是網路)
  2. 當二進位資料以 multi-byte 形式寫入記憶體,並進行單一 byte 讀取的時候,反之亦然

PC Assembly Language 學習筆記(2) - Assembly Language

Machine Language

每種 CPU 僅懂得自己的 machine language,而在 machine language 中的指令相當艱澀難懂不容易閱讀,每個指令都有屬於自己的唯一識別碼,稱為 operation code(或是 opcode),通常位於指令的開頭。

而要讓 CPU 執行工作,必須給他 machine language 才可;然而,直接撰寫 machine code 幾乎是不可能的事情,因此,我們需要可以將 assembly 轉為 machine code 的工具 - assembler。


Assembly Language

assembly 程式是以純文字的方式進行儲存的,其中類似的語法如下:
add eax, ebx
由程式中可以看得出來該行指令所要進行的動作,而將其轉譯成 machine code 的工作,則交給 assembler 來做即可。

而在其他的程式語言中,扮演此種角色(將程式轉為 machine code)的,稱為 compiler,然而 compiler 的複雜度遠遠高過 assembler,原因是因為 assembly code 與 machine code 的關係是一行對一行的,而一般程式語言中的一行就常常產生多行相對應的 machine code。

另外與其他程式語言不同的地方是,每種 CPU 不但有自己的 machine language,也有自己的 assembly language,因此若要將 assembly code 進行 porting,難度會比一般的程式語言高上許多。


Instruction operands (指令運算元)

一般 machine code 的指令中都會包含多個或多種的 operand(運算元),而 operand 大概可以分為以下幾類:
  1. register
    指向儲存於 CPU register 中的植。

  2. memory
    指向儲存於 memory 中的資料,而 memory address 有可能是直接寫於指令中,或是由 register 的值所組成。

  3. immediate
    列於指令中的固定值,儲存於指令本身(在 code segment 中),而非在 data segment 中。

  4. implied
    此種 operand 不會明確的顯示。例如:將某個 register 中的值加 1。


Basic instruction (基本指令)

在程式開發中,最常用到的應該是 mov 指令了,其作用在於進行資料的搬移,語法如下:
mov dest, src
其中 src 中的資料會被複製到 dest 中,而 mov 的使用必須符合以下規則:
  1. 不論是那個 operand(dest 或 src),都不能是 memory address
  2. 兩個 operand 都必須相同大小 (表示 AX 中的值不能 mov 到 BL 中)

以下用一些範例來說明:
mov eax, 3  ;設定 EAX register 的值為 3
mov bx, ax ;將 AX register 的值複製到 BX register

add eax, 4 ; eax = eax + 4
add al, ah ; al = al + ah

sub bx, 10 ; bx = bx - 10
sub ebx, edi ; ebx = ebx - edi

inc ecx ; ecx++
dec dl ; dl--


Directive

Directive 則是人自己手動加入的,而不屬於 CPU 的指令,作用有兩種:
  1. 指示 assembler 要作某些事情
  2. 告知 assembler 某些訊息

而這個部分,並不會被 assembler 轉為 machine code,一般常見的 directive 用法大概有幾種:
  1. 定義常數(constant)
  2. 定義儲存資料的記憶體位置
  3. 將多段記憶體空間組合為 segment
  4. 視情況 include 外部的 source code
  5. include 其他檔案

以下介紹幾種 directive:

The equ directive

用來定義 symbol (有名稱的常數,可用於程式中),而 symbol 定義好之後,其值不可再度變更,語法如下:
symbol equ value

The %define directive

此與 C 語言中的 #define 是很像的,大多用來定義 macro 之用,以下用個簡單範例說明:
%define SIZE 100    ; 定義 macro SIZE 為 100
mov eax, SIZE ; 將 100 存於 EAX register 中
%define 是用來定義 macro 的,與 symbol 不同的是,macro 的值可以變更,且使用上不僅限於存單一值而已,還可以作較為複雜的運算。

Data directives

用於 data segment 中,來保留記憶體空間。使用方式有兩種:
  1. 使用 RESX directive,不給予初始值
  2. 使用 DX directive,給予初始值

其中 X 的部分代表所要保留的記憶體空間大小,分別有 B(byte)、W(word)、D(double word)、Q(quad word)、T(ten byte) .... 等等,而每個記憶體空間都會用一個 label 名稱作為標記以方便使用,以下用簡單範例來說明:
L1  db      0       ; 標記為 L1,大小為 1 byte,初始值:0
L2 dw 1000 ; 標記為 L2,大小為 1 word(2 bytes),初始值:1000
L3 db 110101b ; 標記為 L3,大小為 1 byte,初始值:110101(2進位,10進位為 53)
L4 db 12h ; 標記為 L4,大小為 1 byte,初始值:12(16進位,10進位為 18)
L5 db 17o ; 標記為 L5,大小為 1 byte,初始值:17(8進位,10進位為 15)
L6 dd 1A92h ; 標記為 L6,大小為 1 double word(4 bytes),初始值:1A92(16進位)
L7 resb 1 ; 標記為 L7,大小為 1 byte,未初始化
L8 db "A" ; 標記為 L8,大小為 1 byte,初始值:A(10進位為 65)
以上定義的 7 個記憶體空間,將會是連續的記憶體空間。

連續的記憶體空間還可以用以下方法配置:
L9  db  0, 1 , 2, 3             ; 連續定義 4 個 byte
L10 db "w", "o", "r", "d", 0 ; 定義字串為 word (結束為 \0)
L11 db 'word', 0 ; 同上

若要配置更大的記憶體空間,可以用 TIMES directive 來重複執行:
L12 times   100 db 0    ; 相同於定義 100 次 db 0
L13 resw 100 ; 保留 100 個 word 大小的記憶體空間

當所需要的記憶體空間都配置好後,再來就是使用的問題了,而使用時必須透過 label 來使用,方式有兩種:
  1. 當直接使用 label 名稱時,表示使用的是該記憶體空間的 memory address
  2. 若是 label 加上兩個中括號(例如:[L1]),表示所使用的為該記憶體空間中儲存的值
其實可以將其想像成 C 的 pointer,這樣應該不難了解。

以下有一些使用範例說明:
mov al, [L1]    ; 複製 L1 的值到 AL register
mov eax, L1 ; EAX register 中的值為 L1 的 memory address
mov [L1], ah ; 複製 AH register 中的值到 L1
mov eax, [L6] ; 複製 L6 的值到 EAX register
add eax, [L6] ; EAX = EAX + L6 的值
add [L6], eax ; L6 = L6 + EAX register 中的值
; AL register 大小為 8 bits
; L6 大小為 32 bits (double word)
mov al, [L6] ; 複製 L6 中的前 8 bits 到 AL register
注意最後一行,在 NASM 中,是不會顯示錯誤的,assembler 僅會檢查 lable 是否有使用錯誤的情況發生而已;而這是為了確保若是 lable 沒有加上中括號(表示為 memory address)時可以正常的使用。

然而,其實 assembler 的檢查也蠻嚴格的,以下用的範例說明:
; 這是不行的,會發生 operation size not specified error
; 因為 assembler 不知道要把 1 當成 byte, word, 還是 double word
mov [L6], 1 ; 儲存 1 到 L6

; 所以要指定 size,改成如下:
mov dword [L6], 1
; 表示要將 1 視為 double word 存入(其他如:byte, word, qword, tword)


Input & Output

在高階語言中,都會提供與 I/O 相關的標準 library 可供使用,但在 assembly 中並沒有;因此 assembly 要執行 I/O 相關工作,不是直接存取硬碟,就是必須使用 OS 所提供的功能。

一般來說,在 assembly 中會常常使用到 C 的 I/O library,也是為了標準化的關係。

2008年1月26日 星期六

PC Assembly Language 學習筆記(1) - Computer Organization

Memory (記憶體)

在記憶體中的每個單位為 1 byte,每個 byte 在記憶體中都會被一個唯一的數字所標示出來,此數字即為該 byte 的 memory address(記憶體位址)。

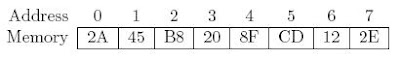
以下用一張圖來表示 memory address:


上圖中,memory address 為 0 的值為 2A,為 1 的值為 45 .... 以此類推;一般來說,memory的使用不會單單只有一個 byte,因為一般的工作都會用到不少的 memory,因此都是一次處理多個 byte。

另外,所有儲存在 memory 中的資料都是數字,而 character(字元) 的呈現則必須仰賴一張對照表將數字轉為字元,其中最有名的即為 ASCII;ASCII 由於每個字元所佔的 memory 為 1 byte,因此可以表現的字元只有 256 個(其實只會用到 7 bits,因此實際僅能呈現 128 的不同字元),而目前越來越流行的 Unicode,則是每個字元所佔的 memory 為 2 bytes,相對的可以呈現的字元又更多,因此常被用來解決多國語言的需求。

以下舉個範例,字元 A 在 ASCII 與 Unicode 的情況下的儲存方式:(0x 開頭表示 Hexadecimal 十六進位)
  • ASCII:0x41
  • Unicode:0x0041


CPU (Central Processing Unit)

在 CPU 中,有一個很重要的部分,稱為 register(暫存器);將特定的資料放到特定的 register,進而執行特殊的指令,這是暫存器的主要用途,當然也可以存放一般資料,而且速度遠遠快過 memory,不過數量有限,使用上必須要注意。

而 CPU 在處理的,稱為 Machine Language(機器語言),這種語言一般人看不懂,通常都是由 compiler 將設計好的程式轉成 Machine Language;一般來說,每種 CPU 都會有他自己的 Machine Language,因此同樣的 Machine Language 在不同架構的 CPU 下是不能正常執行的。


80x86 CPU

x86 架構的 CPU 是目前普及率最高的 CPU,一般的電腦都搭配著這一類的 CPU,以下大概介紹一下這些 CPU:

8088、8086

這一代的 CPU 用於早期的 PC,其中所使用的 register 都是 16 bits,分別是 AX、BX、CX、DX、SI、DI、BP、SP、CS、DS、SS、ES、IP、FLAGS .... 等等。

由於此代 CPU 只能在 real mode 中運作;而在這種模式下,程式最大僅能用到 1MByte 的 memory,且程式中可以存取任何 memory address,甚至是屬於其他程式的 memory address 也可以,因此造成 debug 以及安全上的顧慮。

此外,程式記憶體也被分為多個 segment,其中每一個 segment 不能超過 64K。

80286

比起上一代的 CPU,register 的部分依然只是 16 bits;但此代的 CPU 多了幾個指令,並可以在 16-bit protected mode 中運作;在此種模式下,最大可以用到 16 MByte 的 memory,而且程式之間的 memory address 在存取上不會互相有衝突,但每個 segment 最大還是只有 64K。

80386

此代 CPU 可說是大躍進,除了每個 register(EAX、EBX、ECX、EDX、ESI、EDI、EBP、ESP、EIP、EFLAGS) 都變成 32 bits 外,還另外多了兩個 16 bits 的 register 為 FS 與 GS。

並加入了 32-bit protected mode,在此模式下,最大可以使用到 4 Gbyte 的 memory(此即為 32 bits 作業系統的最大記憶體限制)。

此外,程式依然會被分為多個 segment,但每個 segment 最大可以到 4 GByte。

80486 / Pentium / Pentium Pro

此代 CPU 沒有很特別,主要只是時脈(速度)上的提升。

Pentium MMX

此代的 CPU 加了 MMX(MultiMedia eXtensions) 指令集,用來加速圖形的處理。

Pentium II

此代 CPU 即為 Pentium Pro + MMX 而已,在主要架構上並沒有突破性的改變

Pentium III

僅為時脈(速度)上的提升。


8086 16-bit Registers

在 8086 CPU 中提供了許多 16-bit register,以下分別介紹他們的用途:

general purpose registers

此種 register 有四個,分別是 AX、BX、CX、DX,用來進行處理時存放一般資料用。

其中每一個 16-bit register 都包含了兩個 8-bit register,以下以 AX 為例:

其中 AH 為 higher 8 bits,而 AL 則為 Lower 8 bits。

而有一個觀念必須了解的是,AH 與 AL 實際上是獨立不互相影響的,但對於 AX 來說 AH 與 AL 又是其一部份,這是必須要注意的!

index register

此種 register 有兩種,分別是 SI 與 DI,通常作為 pointer 之用,但也可以拿來跟 general purpose register 一樣使用。

但是與 general purpose register 不一樣的是,index register 並非由兩個 8-bit register 所組成。

base/stack pointer

此種 register 分別為 BP(base pointer) 與 SP(stack pointer),用來指向 machine language stack 中的資料。

segment register

此種 register 有四種,分別是 CS(code segment)、DS(data segment)、SS(stack segment)、ES(extra segment),用來標示 memory 是被哪些不同的程式所使用,其中 ES 是被用來暫時作為 segment register 用。

instruction pointer register

此即為 IP,與 CS 搭配,用來指向下一個 CPU 準備執行的指令所在的 memory address,一般來說,當指令執行後,IP 就會自動指向下一個準備執行的指令所在的 memory address。

FLAGS register

此即為 FLAGS,用來儲存前一個指令執行完後所產生的重要訊息,而這些訊息是以單一 bit 的方式進行儲存。


80386 32-bit Registers

在 80386 CPU 的時代,register 大躍進變為 32 bits。

舉例來說,原本的 AX 變成了 EAX,而為了向下相容的考量,其中 AX 則變為 EAX 的 lower 16 bits,不過需要注意的是,沒有代表 higher 16 bits 的 register,因此沒辦法直接存取 32-bit register 中 higher 16 bits 的部分。

許多原本 16-bit register 都轉變為 32-bit 了,但 segment register 還是有維持原本的 16 bits,另外還多了 FS 與 GS 的 16-bit register,也是作為 segment register 之用。


Real Mode

在 real mode 中,memory 的使用被限制在 1 MByte(220 bytes) 內,可用的 address 範圍為 0x00000 ~ 0xFFFFF。

由 memory address 的可用範圍可知,存取需要 20 bits 的長度,但在 8086 的 CPU 架構中僅有 16-bit register,因此必須使用兩個 16 bits 值的組合來表示一個 memory address。
其中前面的 16 bits 稱為 selector,必須存於 segment register 中,而後面的 16 bits 稱為 offset,其中實際 memory address 的計算方式如下:
16 * selector + offset (即為 selector 補 0 到後方再與 offset 相加)
而 real mode 有幾個問題:
  1. 單一 selector 只能參照到 64K 大小的 memory,但如果程式碼大小超過 64K,就必須強制分成多個片段來執行;同樣的,不只程式碼,連太大的資料也是會有相同問題。

  2. segment address 的衝突問題,舉例來說:04808 可以被以下幾個組合所參照:
    • 047C:0048 (047C0 + 0048 = 04808)
    • 047D:0038 (047D0 + 0038 = 04804)
    • 047E:0028 (047E0 + 0028 = 04808)

由於種種問題,造成在 real mode 中設計程式是一件非常困難的事情。


16-bit Protected Mode

在 80286 CPU 出現後,提供了 16-bit protected mode,其中處理 selector 的部分與 real mode 是完全不同的。

在 real mode 中,selector 用來表示 memory address 的前段部分;而在 protected mode 中,selector 則是 descriptor table 的 index。

說到 program segment,在兩個不同的模式中都必須要做,只是在 real mode 中,program segment 是存於實體記憶體的固定位置上;而在 protected mode 中則不是。

在 protected mode 中儲存 program segment 的方式稱為 virtual memory,基本的觀念即是「僅儲存目前正在執行程式的 code 與 data 在記憶體中,其他程式的 code 與 data 則存放於磁碟機中」,換另外一支程式要跑時,再從磁碟機中移到記憶體中去執行,而這些步驟由 OS 處理,程式中不需考慮到這些實作細節。

在 protected mode 中,所有個 segment 都被視為是 descriptor table 中的一個 entry,此 entry 中包含了許多資訊,包括:是否目前存於記憶體中? 如果在記憶體中,存於那個位置? 存取權限 .... 等等;而每個 entry 的 index 則是 selector 的值,存於 segment register 中。

此外,雖然已經是 protected mode,程式間所使用的 memory 不會互相有影響,但是畢竟 register 還是只有 16 bits,可以處理的資料量還是很少,假設要處理大量的資料依然是一個很大的挑戰。


32-bit Protected Mode

80386 CPU 中出現了 32-bit protected mode,其中與 16-bit protected mode 最主要的差異有兩點:
  1. offset 長度擴充為 32 bits,因此表示每個 segment 最大可以到 4GBytes

  2. 每個 segment 被分為更小的單元,稱為 page,每個 page 大小為 4K。而在 virtual memory 中所處理的單元改為 page 而非之前的 segment;這表示每次程式處理時,只有 segment 中的一部份會在 memory 中,此舉是為了讓 memory 做更有效率的利用。
目前的 Windows 9X, Windows NT/2000/XP, Linux .... 等等,都是屬於 paged 32-bit protected mode。


Interrupts (中斷)

有時候在程式執行的過程中,需要對於特定事件即時回應,而這種機制稱為 interrupt(中斷)。

會造成 interrupt 的情況不只一種,可能是滑鼠移動,或是按下鍵盤 .... 等等,而每種情況都會產生不同的 number 作為識別,並將程式的控制權交給 interrupt handler。

在實體記憶體的開頭,包含了稱為 interrupt vector 的資訊,並存於 table 中,而每個由 interrupt 所產生的 number 則是包含在此 table 中的 index。

interrupt 有分為兩種,分別是 external interrupt 與 internal interrupt;其中 external interrupt 發生於 CPU 之外,有許多裝置都會產生此種 interrupt,包含滑鼠、鍵盤、磁碟機 ... 等等;而 internal interrupt 則是發生於 CPU 內,有可能是因為發生 error(稱為 traps) 或是 interrupt 指令的執行(稱為 software interrupts)。

一般情況下,中斷處理完後,interrupt handler 會將控制權移回程式中,也會復原在原本 interrupt 發生前所有在 register 中的值,但僅有 traps 例外,會造成程式的中斷。

2008年1月20日 星期日

[TCP/IP Illustrated] ICMP

簡介

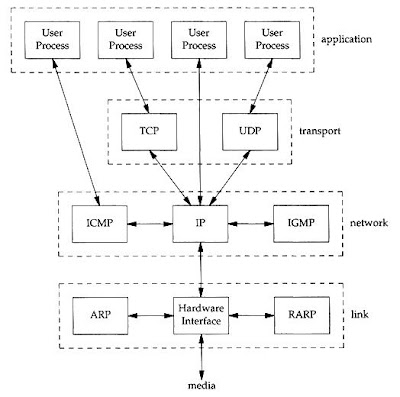
ICMP(Internet Control Message Protocol) 屬於 Network Layer,與 IP 屬於同一層;用途在於當網路傳輸發生異常時,作為警示訊息的通訊之用。

從上面這張圖可以看出,跟 ICMP 往來的協定,除了 IP 之外,還有其他 Application Layer 的協定也會使用到 ICMP。

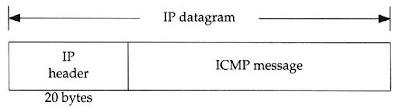
不過由於 ICMP 終究屬於 Network Layer,因此 ICMP 訊息的傳輸還是必須包在 IP datagram 中進行傳輸,以下用兩張圖來表示其格式:


由於是 IP datagram 的關係,因此 ICMP message 的前方必須還要再加上 20 bytes 的 IP header 資訊才有辦法傳送出去。

ICMP 是個很重要的協定,不論是常用的 ping,甚至是處理 IP routing 的時候,都會用到 ICMP;在這個部分,我們將會針對 address mask request/reply、timestamp request/reply、port unreachable error ....等不同型態的 ICMP message 進行說明。


ICMP message Type

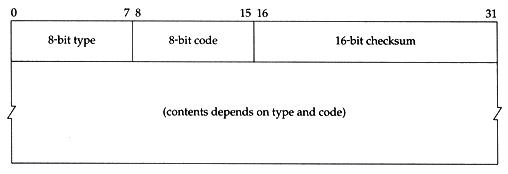
在介紹 ICMP message Type 之前,必須先知道 ICMP message 的結構是如何,以下用依張圖來說明:


其中最前面的 16 bits (0~15) 的 type + code 欄位,即是是用來表示 ICMP message Type,以下用一個表格列出 ICMP message Type:(表格中的最後兩個欄位用來表示 ICMP message 是用來查詢,或是通知有錯誤發生之用)
type
code
描述
Query
Error
0
0
echo reply (ping)
*

3

destination unreachable


0
network unreachable

*

1
host unreachable

*

2
protocol unreachable

*

3
port unreachable

*

4
fragmentation needed but don't-fragment bit set

*

5
source route failed

*

6
destination network unknown

*

7
destination host unknown

*

8
source host isolated (此狀態淘汰不用了)

*

9
destination network administratively prohibited

*

10
destination host administratively prohibited
*

11
network unreachable for TOS

*

12
host unreachable for TOS

*

13
communication administratively prohibited by filtering

*

14
host precedence violation

*

15
precedence cutoff in effect

*
4
0
source quench (elementary flow control)

*
5

redirect


0
redirect for network

*

1
redirect for host

*

2
redirect for type-of-service and network

*

3
redirect for type-of-service and host

*
8
0
echo request (ping)
*

9
0
router advertisement
*

10
0
router solicitation
*

11

time exceeded


0
time-to-live equal 0 during transit (traceroute)

*

1
time-to-live equal 0 during reassembly

*
12

parameter problem


0
IP header bad (catchall error)

*

1
required option missing

*
13
0
timestamp request
*

14
0
timestamp reply
*

15
0
information request
*

16
0
information reply
*

17
0
address mask request
*

18
0
address mask reply
*


由上表可知,ICMP message 有分為 Query 與 Error 兩種;其中若發送的是 ICMP error message,表示在 ICMP message 中一定包含了讓網路通訊發生錯誤的 IP datagram 其中的一些資訊。

其中,針對以下幾種訊息,不會產生 ICMP error message 作為回應:
  1. ICMP error message
    若是會針對 ICMP error message 回應 ICMP error message,那就會變成無限迴圈了....
  2. 目的地為 IP broadcast address 或是 IP multicast address 的 datagram
  3. 在 Link Layer 廣播的 datagram
  4. 切成多段 fragment 的訊息 (第一個 fragment 除外)
  5. 在 source address 欄位部分沒有定義主機資訊的 datagram(這表示 source address 不會是 zero address、loopback address、broadcast address、或是 multicast address)

以上的種種限制,都是為了不讓 ICMP error message 在網路上過於氾濫而造成 broadcast storm。


ICMP address mask request/reply

ICMP address mask request 通常是用在無硬碟的系統上,用來在開機時取得 subnet mask(子網路遮罩) 的資訊,其作用類似 ARP,只不過問的不是 MAC address 而是 subnet mask address。

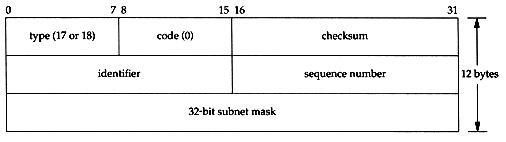
以下用一張圖來說明 ICMP address mask message 的結構:

其中 identifier 與 sequence number 的欄位可由傳送 reply 訊息的人填入任何訊息,再跟著 ICMP address mask reply message 一起回傳。

在這裡有一點必須注意,由於 ICMP message 屬於 broadcast,而在同一個網段內,所有的電腦都會收到 broadcast 訊息,包含自己! (大概是因為 loopback 的機制)

因此若是用 tcpdump 程式去監控機器的封包,若是發出 ICMP request message,有時候會看到自己對此封包的 ICMP reply message。

另外一點需要補充的是,在正常的情況下,包含 ICMP reply 的 IP datagram 中,會指定 IP header 中的 source address 為發送 ICMP request 的機器,而不會是 broadcast。


ICMP timestamp request/reply

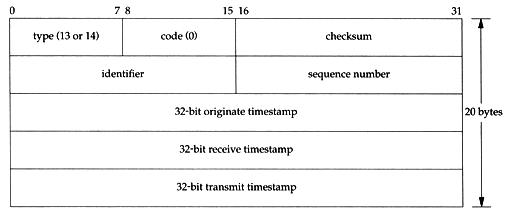
ICMP timestamp request 是用來詢問其他電腦時間之用,以下先介紹 ICMP timestamp message 的結構:


稍微注意一下在 timestamp 的部分有三個欄位,分別是 originate、receive、transmit,透過這三個欄位的搭配計算,就可以將兩台電腦的時間進行同步。

此外,還有其他方法可以取得目前時間,以下舉個例子:
#直接詢問 time server
shell> telnet stdtime.gov.tw daytime


ICMP port unreachable error

上面兩個部分講的都是 query message,這個部分要說的是 error message - port unreachable error。

不論是 TCP or UDP,當傳輸的封包中,在 TCP/UDP header 中的 destination port 欄位所指定的值,對方主機並沒有針對此 port 提供服務,那就會回傳 ICMP port unreachable error。

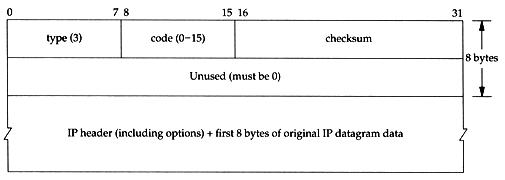
以下用圖來表示 ICMP unreachable message 的結構:


從 ICMP message type 的列表中,光是 destination unreachable (type = 3) 的錯誤就有 16 種(code = 0~15),其中 port unreachable (code = 3) 只是其中一種而已。

以下還是以 port unreachable error 說明一下流程;按照正常的情況下,透過 telnet 去偵測一個未開啟服務的 port,應該會發生以下的事情:
  1. sender 傳送 ARP request 詢問 MAC address
  2. receiver 回傳 ARP reply 告知 MAC address
  3. sender 傳送 destination port 為未提供服務 port 的封包
  4. receiver 回傳 port unreachable error 的錯誤

不過經過 tcpdump 檢測封包的實測結果,第三第四個步驟並沒有相關訊息出現,因此研判有可能是 firewall 的關係。

2008年1月18日 星期五

Digital Signature (數位簽章)

簡介

在資訊安全的原則中,其中非常重要的一環,即為不可否認性(non-repudiation),假設在正常情況下,A 傳訊息給 B,之後就不能否認曾經傳過訊息,此即為不可否認性。

但這應該如何做到呢? 答案就是 Digital Signature(數位簽章)

Digital Signature 的使用情境大概如下:

假設 A 要傳訊息給 B,但是 B 要如何確認訊息真的是由 A 發送的呢?

此時只要 A 在發送前利用自己的 private key 將訊息加密,再傳給 B,B 再利用 A 的 public key 進行解密。

如果訊息可以正確解密,就可以確定訊息是由 A 所發出;即使訊息在傳送過程中被 C 所攔截,再使用 A 的 public key 還原成原本的訊息,還是沒辦法偽裝成 A 所發送的訊息(因為這需要 A 的 private key)。

因此,Digital Signature 的主要作用即是在確定不否可定性(non-repudiation);而 Digital Signature 在實際應用上是很有意義的,因為這項技術代表了授權機制可以很容易建立起來。


Message Digest (訊息摘要)

在深入瞭解 Digital Signature 之前,必須先知道 Message Digest 為何。

顧名思義,Message Digest 即是一段訊息的摘要,類似於 fingerprint(指紋) 的概念;理論上,不同的訊息所產生出來的 message digest 都不會是相同的,因此可以用來驗證訊息在傳輸的過程中是否有被竄改過。

而 message digest 是如何產生的呢? 在目前的作法中,是以複雜的 hash function (雜湊函數) 所計算出來,以下來介紹 hash function ....


Hash Function (雜湊函數)

Hash Function(雜湊函數),在許多地方都可以見到其蹤影,目前常用的 hash function 有 MD5(Message-Digest algorithm 5)、SHA(Secure Hash Algorithm)、MAC(Message Authentication Code)、HMAC(Hash-based Message Authentication Code) .... 等等。

不論是何種 hash function,都具備以下幾點特性:
  1. 要計算出一段訊息的 message digest 不需花太多時間,因此演算法的設計上必須考量到效率
  2. 針對相同訊息進行計算,都會產生出相同結果
  3. 只有 message digest,是無法還原成原訊息,因此演算法的設計上必須是不可逆
  4. 不同的訊息所計算出來的 message digest 必須是不同的

一般來說,上面的四種演算法都具備了上述幾種特性。但還是有一些是必須注意的....

MD5 所計算出來的 message digest 長度為 128 bits,因此表示不同的訊息還是有 1/(2^128) 的可能性發生重複。

SHA 所計算出來的 message digest 長度為 160 bits,強度更甚 MD5,但不同的訊息還是有 1/(2^160) 的可能性發生重複。

上述兩種演算法的發生重複性的機率已經算是極低,到了幾乎可以忽略的地步了,因此實際應用上常常都會遇見;此外,這兩種演算法計算 message digest,所需要的只需原訊息即可,不需要額外的資訊。

與 MD5 和 SHA 不同的是,MAC 與 HMAC 兩個則是需要多一支加密用的金鑰,因此其演算法的設計還是必須以密碼學的演算法為基礎,只是差別在於演算法的設計上不需考慮是否可逆(因為原本就是希望是不可逆的!)。

但使用 MAC 與 HMAC 的一個大問題還是出在金鑰(key),因為這兩種演算法都必須要有一支金鑰,因此永遠都會存在通訊雙方金鑰交換的問題。


Digital Signature 的實際應用

在實際應用上,為了確保 digital signature 的安全與可靠,一般會加上 RSA 非對稱式加密的機制,嚴謹一點就會在 PKI 的架構下,加入可信任第三方的認證,以下用一張圖來表示:
大概描述一下整個流程:
  1. 發送者(Signer)將所要傳遞的資訊透過 hash function 加密以產生 message digest
  2. 發送者使用自己的 private key 將 message digest 加密,結果即為 digital signature
  3. 此時發送者將原始資訊與 digital signature 一起傳送給接收者
  4. 接收者使用相同的 hash function,計算出原始資訊的 message digest
  5. 接收者使用發送者的 public key 將 digital signature 解密,取出 message digest
  6. 比對兩個 message digest,若是相同,則表示資訊來源的確為原始發送者,並沒有被修改過

由上述的說明可知,透過 Digital Signature 的機制,除了可以達到資訊安全中的不可否認性(non-repudiation)外,還可以達到資訊完整性(integrity)的目的。


參考資料
  1. Message Digest
  2. What is a message digest?
  3. TWCA 台灣網路認證 - 訊息摘要(Message Digest)
  4. Digital Signature
  5. 數位簽章是什麼?
  6. 資料加密
  7. 網路認證機制相關說明Q&A

Asymmetric Encryption (非對稱式加密)

簡介

Asymmetric Encryption (非對稱式加密) 即是為了改良 Symmetric Encryption(對稱式加密)的缺點而產生的。

在對稱式加密中,通訊雙方往來的訊息是由同一把金鑰進行加密;假設 A 與 B 通訊,兩個人必須有一把相同的金鑰;而若是 A 也要與 C 通訊,則 A 與 C 則必須擁有另外一把不同的金鑰;否則若是都使用相同金鑰,C 就可以解密出 A 要給 B 的訊息,相對的,B 也可以解密出 A 要給 C 的訊息,如此一來資訊在傳送就不再安全!

除此之外,還要防範金鑰被竊取的問題,只要通訊雙方任何一個人把金鑰洩露出去,也就破壞了原本建立的安全機制了。

因此,Asymmetric Encryption(非對稱式加密) 使用了一對金鑰(key pair)的方式解決了這個問題


Key Pair

在 Asymmetric Encryption 的架構中,要通訊的雙方都各持有一對金鑰,分別是私鑰(private key)以及公鑰(public key)。

顧名思義,private key 是要妥善且由自己秘密保管的,而 public key 則是可以公開出去。

假設使用者 A 有一對金鑰,若是 B 要與 A 進行通訊,則 B 必須使用 A 所提供的 public key 進行加密,再將加密的內容傳送給 A,接著 A 可以用自己的 private key 進行解密。

同樣的,A 要是要傳訊息給 B,則是要使用 B 所提供的 public key 進行加密,而 B 則可以用自己的 private key 進行解密。

有趣的是,雖然訊息是由 public key 所加密的,但是卻無法利用 public key 將原本的訊息還原回來,這就是非對稱式加密的精華所在,也是目前非常受到歡迎的原因。

而這一來一往之間,所使用的演算法,即為 RSA 演算法。


RSA Algorithm

RSA 演算法要如何確保不容易被破解呢? 答案在於「要算出一個很大的數,是由那兩個質數相乘的結果(進行因數分解),是很困難的」,因此可以很明顯看出,RSA 的運作方式,都是以兩個很大的質數為基礎來進行的。

RSA 演算法的基礎,取決於兩個很大的質數(可能達數百位數),運作流程大概如下:
  1. 選擇兩個大質數 P & Q
  2. 計算 N = P * Q
  3. 選擇公鑰(public key) E,使它不為 (P-1) 或 (Q - 1) 的因數
  4. 選擇私鑰(private key) D,讓右邊算式成立:(D * E) % [(P - 1) * (Q - 1)] = 1
  5. 加密過程為:密文(CT) = 明文(PT^E) % N
  6. 解密過程為:明文(PT) = 密文(CT^D) % N

如此看來,其實 RSA 的加解密過程是很簡單的,因此重點就是在於金鑰的產生,目前已經被證明長度 1024 bits 不夠安全,因此建議使用長度為 2048 bits 的金鑰作為加解密之用,來提升重要資訊傳輸的安全性。

最後,雖然非對稱式加密解決了金鑰交換的問題,但是卻衍生出加解密效率不彰的問題,因為相較於 DES,RSA 的速度只有其百分之一不到。


Asymmetric + Symmetric

真的沒有更好的 solution 嗎? 當然是有的......只要巧妙的結合兩者的優點即可啦!!

其中的原理很簡單,假設 A 要傳訊息給 B,就會發生大概類似以下流程:
  1. A 透過對稱式演算法,產生出一把對稱式加密用的金鑰(注意:這把金鑰只用在這一次的傳輸)
  2. 接著 A 使用 B 所提供的 public key,將這把金鑰加密,並將加密後的內容傳給 B
  3. B 接收到後,使用自己的 private key 解密,取得這把一次性金鑰
  4. 接著之後雙方訊息的往來,都使用對稱式加密

如此一來,就不僅解決了金鑰交換的問題,也解決了非對稱式加解密效率不彰的問題。

當然,這樣的 solution 其實還不算最安全,因此才會有 Digital Signature(數位簽章) 的誕生......


參考資料
  1. RSA 加密演算法
  2. RSA 加密演算法(PDF)
  3. developerWorks - 讓軟體運轉:歷經考驗的真正加密

2008年1月17日 星期四

Symmetric Encryption (對稱式加密)

簡介

Symmetric Encryption - 對稱式加密,其特色在於加解密所使用的金鑰(key)是相同的!

兩方要進行秘密訊息的傳送之前,必須協議出一個共同的,用來加解密的金鑰(key)以及所使用的演算法;如此一來訊息一來一往之前才可以被正確的加解密。

當 然這樣的方式會衍生出一些問題,因此才會有 Asymmetric Encryption(非對稱式加密) 的產生,來改善一些 Symmetric Encryption 的缺點;然而 Symmetric Encryption 在實際的應用上有其實用性,因此目前還是持續不斷的被使用當中。

在加解密運作的機制中,有兩大重要部分,除了金鑰(key)之外,另外一個即為加解密所使用的演算法(algorithm)。

在實際應用上,金鑰(key)是一個檔案,內容為一群無意義的英文與數字的集合,長度範圍有可能介於 64~1024 bits (甚至更大) 之間,妥善由通訊雙方秘密保管好。

而演算法(algorithm)則是透明公開的,隨時可以從網路或是其他地方取得演算法的相關使用方法與規則。

以下先針對對稱式加密演算法的型態(Type)與模式(Mode)進行說明,後面再介紹目前常用的演算法.......


演算法型態(Algorithm Type)

演算法在型態部分,有分成兩種,分別是:

Stream Cipher

此種方式是將 plain text 中的每一個 bit 逐一加密,然而此種方式在效率上並不好,因此目前比較為大家所熟悉且常用的演算法,都不是使用 stream cipher 的方式進行處理。

Block Cipher

此種方式將 plain text 分成多個 block(區塊) 後,一次針對一個 block 進行加密處理。

此種方式有個很明顯的問題存在,就是當所加密的 plain text 相同時,加密的結果也會相同;如此一來,有心人就可以根據加密的結果,判斷出訊息中的哪幾個部分是相同的,進而嘗試進行破解。

當然,這個問題是很顯而易見的,因此就有人提出不同的解決方式,這個部分會繼續在演算法模式(Algorithm Mode)中進行說明。


演算法模式(Algorithm Mode)

演算法模式(Algorithm Mode)是針對 Block Cipher 所設計的一系列加解密方式,其中有四個重要的模式,分別是:
  1. Electronic Code Block (ECB)
  2. Cipher Block Chaining (CBC)
  3. Cipher Feedback (CFB)
  4. Output Feedback (OFB)

前 面兩種模式所使用的為 block cipher,因此加密時是以一個區塊為單位進行處理;而後面兩種雖然也是屬於 block cipher,但由於加入了 Initialization Vector 以及 Offset 的觀念,因此處理起來類似stream cipher 的方式。

以下針對四種模式逐一介紹:(解密方式多為加密方式的反推,所以以下僅說明加密的方式)

Electronic Code Block

首先,先用圖來表示 ECB 加密的過程:
顯而易見的,ECB 即為標準的 block cipher,將要加密的 plain text 分為多個 64 bits 的區塊,並用同一支金鑰進行加密的動作。

由於重複的加密訊息有可能出現,因此僅適合用來加密長度很短的訊息。


Cipher Block Chaining

有鑑於此,有人提出了 CBC,即是用來解決上面缺點,以下先用圖來表示加密的過程:
其中一開始的 IV 值是隨機產生的,接著當使用金鑰加密第一個區塊的 plain text 後,在將加密後的結果作為加密第二個區塊的輸入。

如此一來,即使兩個區塊的 plain text 內容是相同的,也不會有同樣的 cipher text 出現了!


Cipher Feedback

有時候在某些情況下,還是必須針對一個一個字元來加密,例如:在終端機打字傳送訊息至遠方。

此時便會使用 stream cipher,而在 CFB 模式中,每個資料加密的單元(通常為 8 bits)會小於一般區塊的大小(通常為 64 bits),以下用圖來說明:

實際上詳細運作方式可能沒辦法從圖上看的出來,不過大概如下:
  1. IV 與金鑰進行加密(假設結果為 64 bits)
  2. 取 64 bits 結果的前面 8 bits 與 plain text 進行 XOR 的運算
  3. IV 左移 8 個 bits,並將運算後的 8 bits 加到 IV 之後(這個部分圖片沒有畫出來.....不過此時 IV 還是 64 bits)
  4. 將第三個步驟所產生的結果作為下一回合的輸入
  5. 重複上面步驟直到所有內容加密完成

如此一來,便可以類似 stream cipher 的方式進行加密,而不用在乎每個區塊的 plain text 長度了!


Output Feedback

OFB 的步驟幾乎與 CFB 是相同的,僅是輸出入稍有差異,以下用圖來表示:

參考資料
  1. Stream cipher
  2. Block cipher
  3. Block cipher modes of operation
  4. IBM - developerWorks:對稱密碼學


常用的加密演算法

說到常用的對稱式加密演算法,大概就是 DES、Triple DES、IDEA、Blowfish、RC5、AES 這一些演算法了。

這一些演算法的處理方式,大概都不會跳脫上面部分所提到的那幾種模式,也就是 Substitution 以及 Transposition 的交互運用,其中的差異僅在於其複雜度而已。

演算法的細節在這邊就不進行說明了,網路上有很多資料可以查,以下大概僅簡介一下:

DES (Data Encryption Standard)

DES 屬於 block cipher,每個區塊的大小為 64 bits,所使用的金鑰長度為 56 bits(其實原本的金鑰長度為 64 bits,但是有 8 bits 會被捨棄不用),經過一連串複雜的 substitution 以及 transposition 的運算處理過程,產生出 64 bits 的 cipher text。

加密過程可以參考此網頁。

其實 DES 已經是個強度很強的加密演算法,以目前電腦的運算能力進行破解,也要花上很多年。


Triple DES

DES 雖然加密強度已經很強,不過當未來出現了運算能力更強的電腦,或是平行運算技術更加成熟後,難保不會在短時間內被破解,因此就有人提出 Triple DES 的演算法。

顧名思義,Triple DES 即是將 plain text 進行三次 DES 的運算處理,有兩種方式:
  1. 使用三把金鑰(K1, K2, K3)
    這個部分比較容易瞭解,很單純的在三次 DES 加密的過程中,分別使用不同的三把金鑰。
  2. 使用兩把金鑰(K1, K2)
    這個部分則是有些變化,大概說明其運作步驟:
    (1) 第一次 DES 加密使用金鑰 K1,假設產生的加密結果為 C1
    (2) 第二次則是以金鑰 K2 對 C1 進行解密,假設產生 C2
    (3) 最後一次則是再以金鑰 K1 對 C2 進行加密

透過此種多重加密的方式,確保 Triple DES 的安全性再更上一層! (當然也要多花點運算處理的時間.....)


IDEA (International Data Encryption Algorithm)

IDEA 亦屬於 block cipher,其加密強度比起 DES 更強,因為所使用的金鑰為 128 bits,而每一次處理的區塊資料長度一樣為 64 bits。

不過由於這是有專利的,因此相較於 DES,並沒有這麼普及。

運作原理大致上跟 DES 不會差異太多,只是一些細節的部分有所差異,詳細過程可以參考以下兩篇文章:
  1. International Data Encryption Algorithm
  2. IDEA 密碼系統


RC5

RC5 也是屬於 block cipher,此演算法是相當有彈性的,不僅可以自訂每個加密區塊的長度,也可以自訂加密的回合數與金鑰的長度,加上只使用了電腦的基本運算(加法、XOR ... etc),因此不僅彈性很大,速度也很快。

而由於 RC5 演算法相較於其他演算法,所需要的記憶體比較少,因此也可以用在可攜式的裝置上。

其他詳細的說明及演算法的運作方式可以參考以下文章:
  1. RC5
  2. RC5 密碼系統
  3. RC5 操作模式


Blowfish

Blowfish 演算法優點在於速度快、記憶體花費少、加解密的過程簡單(僅使用到基本運算)、可自訂金鑰長度。

而此演算法適合用在通訊連結上,因此像是 VPN 連線的加密,就有使用 Blowfish 演算法。


AES (Advanced Encryption Standard)

由於對於暴力破解法,DES 有可能被破解的風險,因此美國政府提出了一個強度更強的演算法,進而想要將加解密演算法標準化,準備當電腦運算能力發展到很強,DES 必須被淘汰時的候補演算法標準,這就是 AES 的由來。

相較於 DES,AES 演算法中所使用的區塊長度為 128 bits,金鑰長度也提高到 128 bits 以上,因此 cipher text 被破解的機會便更低了。

若要瞭解 AES 詳細的運作方式,可以參考以下文章:
  1. AES 基本架構
  2. AES 加密演算法 - 加密編碼
  3. AES 加密演算法 - 金鑰擴充
  4. AES 解密演算法

2008年1月13日 星期日

C - File attributes

今天在研究怎麼取得檔案的相關屬性,簡單的以檔案大小為例

在書中說使用 io.h head file 搭配 filelength() function 就可以取得....

在 Windows 中似乎沒問題,不過在 Linux 上似乎就不行了,於是上網查了一下資料,發現要使用 stat(const char *filename, struct stat *buf) function 才可以取得檔案屬性

而若要用此 function,必須要引用「sys/stat.h」 head file,裡面定義了 stat struct,其中有許多 member 分別表示不同的 file attribute,詳細可以參考「The meaning of the File Attributes」一文。

接著是 stat 的使用方式,可以參考「Reading the Attributes of a File」一文,以下用個簡單範例來說明:
#include <stdio.h>
#include <stdlib.h>
#include <sys/stat.h>

int main(void)
{
//開啟檔案
FILE *fptr;
fptr = fopen("fileTest.txt", "r")

//取得檔案屬性
struct stat myFileStat;
stat(fpath, &myFileStat);
printf("file serial number : %d\n", myFileStat.st_ino);
printf("device contains the file : %d\n", myFileStat.st_dev);
printf("user ID : %d\n", myFileStat.st_uid);
printf("group ID : %d\n", myFileStat.st_gid);
printf("file size in bytes : %d\n", myFileStat.st_size);
printf("last access time : %d\n", myFileStat.st_atime);

//關閉檔案
fclose(fptr);

return 0;
}
上面只介紹了一部份的屬性,詳細的屬性資訊可以參考上面的連結。

C - fgets & strncmp & strrchr

今天練習寫 C 時,使用了在 stdio.h 中所提供的 char *gets(char *str) function,但是在 compile 的時候卻出現了以下警告訊息:
warning: the `gets' function is dangerous and should not be used.
喔? 這個 function 竟然被 compiler 說是危險不應該使用的.....原因是為何呢?

看到了以下兩篇文章,終於知道了答案:

原來當輸入的值超過接收這個值的變數範圍時,就會有 overflow 的情況發生。

overflow 又會怎樣呢? 這讓我想起了之前參加 OpenSource 研討會時,有一個講 Embedded System Security 的主講人有提到這個,overflow 的確會造成資訊安全上的漏洞,因此這個情形要盡量應該避免。

那要用什麼才會比較安全呢? 答案是 char *fgets(char *str, int num, FILE *stream) function,透過第二個參數可以指定最多可以取得多長的字串,如此一來,就不怕因為使用者亂輸入而造成 overflow 的情況發生了!

但是需要注意的是,函式所取得的長度是 (num - 1) 並非 num 喔! 這是需要注意一下的地方。


另外,取得值之後,若要跟另外的字串做比較,一般來說是用 int strcmp(const char *s1, const char *s2) function,若兩個字串相同,則回傳 0。

但是我怎麼試都不是 0,明明輸入的字串跟原本的字串都相同阿?

後來才發現,我用 fgets 取得輸入值,在 BufferSize 的地方設定為 10(也就是說最多取到長度為 9),而輸入值的長度只有 5,於是 fgets 很好心的幫我在字串後面加上 New Line(\n) 的標記..........就是因為這樣比對出來才不會是 0!!!

用 strcmp 看來是不行了,於是找了一下,發現有 int strncmp(const char *s1, const char *s2, size_t n) function 可以用,透過此 function 就可以指定比對的字串以及所要比對的長度囉!!

因此,我只要在第三個參數的部分設定為 5 即可!


還有另外一個 solution,即是透過 fgets 取得輸入後,將最後的「\n」給去除,只要用以下的程式碼即可:
#include <string.h>
char *usrInput;
*strrchr(usrInput, '\n') = '\0';

2008年1月12日 星期六

AntiVir(小紅傘)使用詳細教學

剛剛偶然在網路上搜尋到的....

作者很詳細的將使用方式分門別類介紹出來,以下是網址:

海芋小站 - AntiVir(小紅傘) 使用介紹

2008年1月11日 星期五

C - Function Pointer

今天在研究 C Function Pointer 的部分,原本有些誤解,後來查了一些資料後,終於釐清 Function Pointer 的觀念了!

Function Pointer 顧名思義,就是指向 Function 的指標

在 C 語言中,不論是 variable、array、struct、或是 function(一段程式碼),都有所屬的啟始記憶體位置

由此可知,main function 也是有其啟始記憶體位置。

而 function pointer 的宣告跟使用 function 時所要注意的地方是相同的,有以下幾點必須注意:
  1. 回傳值型態(return type)
  2. 參數數量(augument count)
  3. 參數型態(argument type)

以下直接用一個簡單範例來說明 function pointer 的使用:
#include <stdio.h>

//function宣告
int doAdd(int, int);
int doMinus(int, int);

int main(void) {
//宣告 function pointer
//注意所設定的參數數量與型態
int (*my_func_ptr)(int, int);

//function pointer 指向 doAdd
my_func_ptr = doAdd;
printf("function pointer 指向 doAdd => %d\n", (*my_func_ptr)(5, 3)); //結果:8

//function pointer 指向 doMinus
my_func_ptr = doMinus;
printf("function pointer 指向 doMinus => %d\n", (*my_func_ptr)(5, 3)); //結果:2

return 0;
} //end main


int doAdd(int a, int b) {
return a + b;
} //end doAdd

int doMinus(int a, int b) {
return a - b;
} //end doMinus
從上面的範例可以看出,doAdd() 與 doMinus() 兩個 function 的回傳值型態、參數數量、參數型態都是相同的,只是名稱不同而已。

而名稱不同,卻不影響 function pointer 的使用,因為我們所用的是 function 的啟始記憶體位置

而 function pointer 的使用,有一點相當重要,即是 function pointer 的宣告;而 function pointer 的宣告,即是要注意到「回傳值型態」、「參數數量」、「參數型態」這三個部分。

當 function pointer 的宣告完成後,另外一個需要注意的就是每個 function 的啟始記憶體位置;而每個function 的啟始記憶體位置,即為 function 的名稱。

在程式中,就是透過將 function pointer 指向不同 function 的啟始記憶體位置,來執行不同的 function。


參考資料