2008年2月23日 星期六

PC Assembly Language 學習筆記(8) - Arrays

陣列的定義

陣列是一個連續的記憶體空間,每個元素的大小、型態皆相同,在 assembly 中定義陣列的方式很簡單,以下用個範例來說明:
segment .data
;宣告長度為 10 的陣列,每個元素大小為 double word,並分別初始化元素的值為 1, 2, 3, ....., 10
a1 dd 1, 2, 3, 4, 5, 6, 7, 8, 9, 10

;宣告長度為 10 的陣列,每個元素大小為 word,初始化所有元素的值為 0
a2 dw 0, 0, 0, 0, 0, 0, 0, 0, 0, 0

;與上一個宣告相同,但使用 TIMES 關鍵字表示重複指令的次數
a3 times 10 dw 0

;宣告長度為 200 的陣列,每個元素大小為 word,每一個元素的值為 1
a4 times 200 dw 1

segment .bss
;宣告長度為 10 的陣列,每個元素大小為 double word,未初始化
a5 resd 10

;宣告長度為 200 的陣列,每個元素大小為 word,未初始化
a6 resw 200

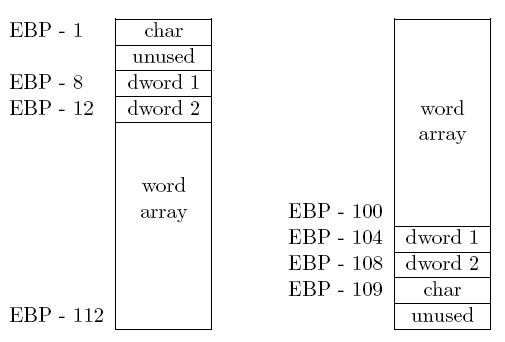
而若要在在 stack 將陣列定義為 local 變數呢? 假設需要的空間有 1 個 char、2 個 double word、50 個 word 元素的陣列,一共需要 1 * 1 + 2 * 4 + 50 * 2 = 109 個 bytes 的空間,從之前介紹過的程式來看,有兩種方法可以達成,一個是透過 [ESP - 109] 的方式來保留記憶體空間,另一個則是用 ENTER 指令來保留空間,以下為保留記憶體空間後的 stack 圖示:


陣列的存取

在 assembly 中存取陣列的元素值,並非像 C 或其他高階語言一樣,使用中括號([])加索引的方式,而是必須要清楚指定 memory address(以 byte 為單位),以下用幾個範例來說明:
;定義兩個陣列,每個元素的大小分別為 byte 與 word
byteArray db 5, 4, 3, 2, 1
wordArray dw 5, 4, 3, 2, 1

;存取 byte 陣列
mov al, [byteArray] ;AL = byteArray[0]
mov al, [byteArray + 1] ;AL = byteArray[1]
mov [byteArray + 3], al ;byteArray[3] = AL

;存取 word 陣列
mov ax, [wordArray] ;AX = wordArray[0]
mov ax, [wordArray + 2] ;AX = wordArray[1] 注意! 這邊 + 2 bytes 即是 + 1 word
mov [wordArray + 6], ax ;wordArray[3] = AX
mov ax, [wordArray + 1] ;這是錯誤的用法,因為元素大小為 word(2 bytes)
以下介紹如何將陣列的值進行加總:
    mov     ebx, byteArray      ;將 byteArray 的初始位址存到 EBX 中
mov dx, 0 ;總和存於 DX 中
mov ah, 0 ;為了確保 AX = AL,因此要清空 AH
mov ecx, 0 ;loop 的次數以 ECX 中的值為主,每次遞減
lp:
mov al, [ebx] ;AL = *EBX
add dx, ax ;add 指令兩端 operand 的大小必須相同
inc ebx ;移至陣列的下一個元素
loop lp

接著用範例說明陣列的操作方式:
// ==================== array1c.c ====================
#include <stdio.h>

int asm_main(void);
void dump_line(void);

int main() {
int ret_status;
ret_status = asm_main();
return ret_status;
} //end main

void dump_line() {
int ch;
while((ch = getchar()) != EOF && ch != 'n')
;
} //end dump_line


; ==================== array1.asm ====================
%define ARRAY_SIZE 100
%define NEW_LINE 10

segment .data
FirstMsg db "First 10 elements of array", 0
Prompt db "Enter index of element to display: ", 0
SecondMsg db "Element %d is %d", NEW_LINE, 0
ThirdMsg db "Elements 20 through 29 of array", 0
InputFormat db "%d", 0

segment .bss
array resd ARRAY_SIZE

segment .text
extern puts, printf, scanf, dump_line
global asm_main
asm_main:
enter 4, 0 ;預留空間給 local 變數用,長度為 double word [EBP - 4]
push ebx ;保留 EBX 的值,先存入 stack 中
push esi ;保留 ESI 的值,先存入 stack 中

;初始化陣列值為 100, 99, 98, 97, .....
mov ecx, ARRAY_SIZE
mov ebx, array
init_loop:
mov [ebx], ecx
add ebx, 4
loop init_loop

push dword FirstMsg ;印出 FirstMsg
call puts
pop ecx

push dword 10
push dword array
call print_array ;印出陣列中的前十個元素
add esp, 8 ;使用 C function 後必須回復原本 ESP 指向的位址(使用 2 個 stack 空間)

Prompt_loop:
push dword Prompt
call printf
pop ecx ;將 Prompt 的 memory address pop 到 ECX 中(沒意義,只是將其從 stack 中移除)

lea eax, [ebp - 4] ;EAX = local 變數的位址
push eax
push dword InputFormat
call scanf
add esp, 8 ;使用 C function 後必須回復原本 ESP 指向的位址(使用 2 個 stack 空間)
cmp eax, 1 ;EAX = scanf 的 return value
je InputOK

call dump_line
jmp Prompt_loop

InputOK:
mov esi, [ebp - 4]
push dword [array + 4 * esi]
push esi
push dword SecondMsg
call printf
add esp, 12 ;使用 C function 後必須回復原本 ESP 指向的位址(使用 3 個 stack 空間)

push dword ThirdMsg
call puts
pop ecx ;將 ThirdMsg 的 memory address pop 到 ECX 中(沒意義,只是將其從 stack 中移除)

push dword 10
push dword array + 20 * 4
call print_array
add esp, 8 ;呼叫 function 後必須回復原本 ESP 指向的位址(使用 2 個 stack 空間)

pop esi ;還原 ESI 的值
pop ebx ;還原 EBX 的值
mov eax, 0 ;回到 C 程式中
leave
ret

; routine : _print_array
; C 程式
; void print_array(const int *a, int n);
; 參數:
; (1) a - 指向陣列的 pointer [EBP + 8]
; (2) n - 要印出的元素數量 [EBP + 12]
segment .data
OutputFormat db "%-5d %5d", NEW_LINE, 0

segment .text
global print_array
print_array:
enter 0, 0
push esi ;保留 ESI 的值,先存入 stack 中
push ebx ;保留 EBX 的值,先存入 stack 中

xor esi, esi ;ESI = 0
mov ecx, [EBP + 12] ;迴圈次數
mov ebx, [ebp + 8] ;EBX = 陣列位址
print_loop:
push ecx ;printf 可能會改變 ECX 中的值,因此先存入 stack 中作保留

;呼叫 C 語言中的 printf,使用的 stack 中的資料作為參數
;分別為(1)OutputFormat (2)ESI (3)陣列值
push dword [ebx + 4 * esi]
push esi
push dword OutputFormat
call printf
add esp, 12 ;使用 C function 後必須回復原本 ESP 指向的位址(使用 3 個 stack 空間)

inc esi ;index++
pop ecx ;還原 ECX
loop print_loop

pop ebx ;還原 EBX 的值
pop esi ;還原 ESI 的值
leave
ret


Array/String Instructions

在 80x86 的 CPU 中,設計了許多用來處理 array 的指令,這些指令稱為 string instruction,他們利用 index register(ESI、EDI) 做為索引之用,並搭配 FLAGS register 中的 direction flag(DF) 來判斷索引為遞增或遞減,其中有兩個指令可用來設定 direction flag:
  • CLD(clears the direction flag):將 DF 設定為 0,為遞增
  • STD(sets the direction flag):將 DF 設定為 1,為遞減

Reading & writing memory

首先先說明讀寫記憶體內容所使用的指令:
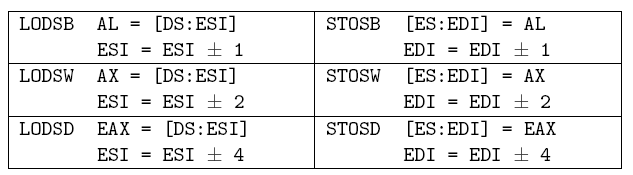
左邊的部分是 read memory,右邊則是 write memory;而從上面這個表中,有三個部分是需要注意的:
  1. 實際資料存放的位置
    LOASx 的部分,是存放在 data segment 中;STOSx 的部分則是存放在 extra segment 中
  2. 所使用到的 index register
    LOASx 使用的是 ESI(source index);STOSx 則是使用 EDI(destination index)
  3. 每次迴圈,index register 所遞增的值
    根據不同的資料長度,分別為 1(byte)、2(word)、4(double word)

此外,還可以注意到所使用的 segment 為 data segment(左邊) 與 extra segment(右邊),以下用一個簡單範例來介紹:
segment .data
ary1 dd 1, 2, 3, 4, 5, 6, 7, 8, 9, 10

segment .bss
ary2 resd 10

segment .text
cld ;將 direction flag 設定為 0,讓 index register 的動作為遞增
mov esi, ary1 ;將 ary1 的 memory address 放到 ESI
mov edi, ary2 ;將 ary2 的 memory address 放到 EDI
mov ecx, 10 ;為了執行迴圈 10 次

lp:
;將每個在 ary1 中的元素複製到 ary2 中
lodsd ;load single double word
stosd ;store single double word
loop lp
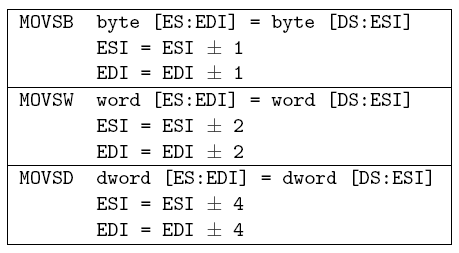
而上述的效果,還可以用 MOVSx 指令來達成,而 MOVSx 指令的使用可以參考下表:

上述的 mov 所處理的資料大小是不同的,因此使用上就必須注意一下囉! 在上一個範例中,LODSD 與 STOSD 的結合,其實用 MOVSD 就可以達到相同效果囉!!!


REP 指令


講完 loop 的寫法後,一定要提到 REP 指令,其實這個指令就是 repeat 的意思,也是以 ECX 中的值作為重複次數的依據,而且可以用很簡單的語法就可以完成,以上面程式的最後三行為例(lp label 後的三行),可以改成以下這一行:
rep movsd ;MOVSD 的效果可以參考上表
以下用一段範例程式碼將陣列所有元素初始化為 0:
segment .bss
ary resd 10

segment .text
cld ;讓 index register 為遞增
mov edi, ary
mov ecx, 10
xor eax, eax ;下一個指令會用到 EAX
rep stosd ;[EDI] = EAX (使用 extra segment,EDI += 4)

Comparison 相關指令

接著這邊介紹的是用來進行比對的指令,這些指令用來比較 register 與 memory 的值,以下用一張圖來介紹有哪些指令可用:
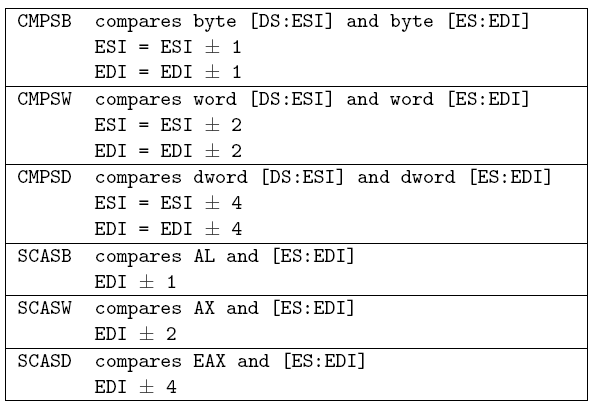
以上這些指令,跟 CMP 相同,也是會修改 FLAGS register 中的值做為程式判斷的依據,以下用一段簡單的程式碼來說明使用方式:
segment .bss
ary resd 100

segment .text
cld ;index register 為遞增
mov edi, ary
mov ecx, 100
mov eax, 12 ;為了找尋陣列中有無元素值為 12

lp:
scasd ;比對 EAX 與 [ES:EDI] 的值
je found ;有尋找到,跳至 found label
loop lp
;=====================
;找不到的時候,所要執行的程式碼放這
;=====================

found:
sub edi, 4 ;確定目前 EDI 所儲存的為指向 12 元素的 pointer
;=====================
;找到以後,所要執行的程式碼放這
;=====================

REPx 指令

REPx 指令與 REP 是類似的,都是作為 repeat 指令之用,以下先用張圖來說明有哪些相關指令:
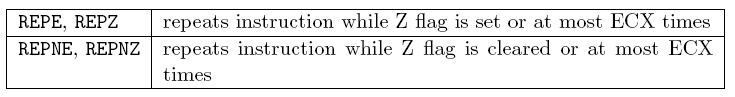
而 REPx 通常用來與 comparison 指令進行搭配,而若是有比對相同,程式並不會因此停止執行,index register 會持續遞增,而 ECX 則是會持續遞減,直到條件達到(Z flag=1/0 或 ECX=0)為止。

以下用一段比對 memory block 的程式來說明 REPx 的使用方式:
segment .text
cld
mov esi, block1 ;第一個 memory block 的 address
mov edi, block2 ;第二個 memory block 的 address
mov ecx, size
repe cmpsb ;持續的比對每一個 byte,直到 Z=1 或是 ECX=0
je equal

;=====================
;比對不同,所要執行的程式碼置於此處
;=====================

jmp onward ;必須跳離,不然會執行到 equal Label 去

equal:
;=====================
;比對相同,所要執行的程式碼置於此處
;=====================

onward:

範例說明

最後用一個較為完整的範例來說明這些指令的使用:

memory.asm
global  asm_copy, asm_find, asm_strlen, asm_strcpy

segment .text

; function: asm_copy
; 用途:複製 memory block
; C functin 定義 :
; void asm_copy(void *dest, const void *src, unsigned sz);
; 參數說明 :
; (1) dest - 指向目的地位址的 pointer
; (2) sec - 指向來源端位址的 pointer
; (3) sz - 要複製的 byte 數量
%define dest [ebp + 8]
%define src [ebp + 12]
%define sz [ebp + 16]

asm_copy:
enter 0, 0
push esi ;保留 ESI 與 EDI 的值(先存入 stack)
push edi

mov esi, src
mov edi, dest
mov ecx, sz

cld ;指定 index register 為遞增 (direction flag = 0)
rep movsb ;[ES:EDI] = [DS:ESI] (ESI += 4 、 EDI += 4)

pop edi ;還原 ESI 與 EDI 的值
pop esi
leave
ret


; function: asm_find
; 用途:在記憶體中尋找指定的 byte
; C functin 定義 :
; void *asm_find(const void *src, char target, unsigned sz);
; 參數說明 :
; (1) src - 指向來源端位址的 pointer
; (2) target - 所要尋找的 byte 值
; (3) sz - 所要尋找的 memory block 大小
; 回傳值說明 :
; 若找到指定的值,回傳指定該值的 pointer;若無,回傳 null
;
; 注意:尋找的是 byte,但因為使用到 stack,因此要把他當作 double word 來處理(使用 lower 8 bits)
%define src [ebp + 8]
%define target [ebp + 12]
%define sz [ebp + 16]

asm_find:
enter 0, 0
push edi

mov eax, target
mov edi, src
mov ecx, sz

cld
repne scasb ; scan memory block 的值,直到 ECX=0 或是 [ES:EDI]=AL

je found_it
mov eax, 0 ;未發現,回傳 null pointer
jmp short quit

found_it:
mov eax, edi ;由 C 呼叫 assembly function 時,回傳值必須存在 EAX 中(因為長度為 double word)
dec eax ;讓 pointer 指向正確的位址

quit:
pop edi
leave
ret


; function: asm_strlen
; 用途:回傳字串的長度
; C functin 定義 :
; unsigned asm_find(const char *);
; 參數說明 :
; (1) src - 指向字串的 pointer
; 回傳值說明 :
; 字串長度(會存入 EAX 中)
%define src [ebp + 8]

asm_strlen:
enter 0, 0
push edi

mov edi, src ;將 string pointer 放到 EDI 中
mov ecx, 0FFFFFFFFh ;設定 ECX 為最大
xor al, al ;AL=0

cld
repnz scasb ;尋找字串結尾(\0)

mov eax, 0FFFFFFFEh
sub eax, ecx ;length = 0FFFFFFFEh - ecx

pop edi
leave
ret


; function: asm_strcpy
; 用途:複製字串
; C functin 定義 :
; void *asm_strcpy(char *dest, const char *src);
; 參數說明 :
; (1) dest - 指向複製來源字串的 pointer
; (2) src - 指向複製目的地字串的 pointer
%define desc [ebp + 8]
%define src [ebp + 12]

asm_strcpy:
enter 0, 0
push esi
push edi

mov edi, dest
mov esi, src

cld
cpy_loop:
lodsb ;將字元讀取到 AL 中,並遞增 ESI 的值
stosb ;將字元從 AL 中讀取出來,並遞增 EDI 的值
or al, al ;設定 condition flags
jnz cpy_loop ;尚未遇到結束字元(\0),繼續執行

pop edi
pop esi
leave
ret
memex.c
#include <stdio.h>

#define STR_SIZE 30

void asm_copy(void *, const void *, unsigned);
void * asm_find(const void *, char target, unsigned);
unsigned asm_strlen(const char *);
void asm_strcpy(char *, const char *);

int main(void) {
char st1[STR_SIZE] = "test string";
char st2[STR_SIZE];
char *st;
char ch;

asm_copy(st2, st1, STR_SIZE); //呼叫 assembly function
printf("%s\n", st2);

printf("Enter a char: ");
scanf("%c%*[^\n]", &ch);
st = asm_find(st2, ch, STR_SIZE); //呼叫 assembly function
if(st)
printf("Found it: %s\n", st);
else
printf("Not Found\n");

st1[0] = 0;
printf("Enter string: ");
scanf("%s", st1);
printf("len = %u\n", asm_strlen(st1)); //呼叫 assembly function

asm_strcpy(st2, st1); //呼叫 assembly function
printf("%s\n", st2);

return 0;
} //end main

編譯、執行指令
shell> nasm -f elf memory.asm ; gcc -o memex memex.c memory.o ; ./memex

2008年2月21日 星期四

Google Gears 架構簡介

離線資料庫的考量

在一般的 web application 中,資料的儲存都是在 server 端負責的,因此一般的流程都是從 server 取得資料後在 client browser 中顯示,若要讓 web application 可以離線(offline)運作,有幾個因素必須要考量到:
  1. 必須將 data layer 的部分獨立出來
  2. 有哪些功能是需要離線運作的
  3. server 與 client 資料同步的問題


Google Gears 離線架構說明

以下用圖來比較以下一般的 web 架構與 Google Gears 所提出的離線 web 架構:

一般架構:
離線架構:
看了上面的架構圖後,其實應該也不太難揣測 Google Gears 是怎麼運作的了。

將一般架構與離線架構相比較,可以發現在離線架構中扮演最重要的角色的即為「Data Layer」與「Data Switcher」,說明以下兩者所負責的工作。

Data Layer

Data Layer 所負責的工作其實很簡單,最主要的部分是將 application 的資料需求 pass 到 server,並接收 server 所回來的資料,再將資料交給 application 做處理。

通常提供了一組 API 供 application 來呼叫,可能有些複雜的資料處理、轉換工作都會在 Data Layer 中完成。

Data Switcher

Data Switch 所扮演的角色就相對很重要了,在整個架構中,Data Switch 為 Application 與 Data Layer 的中介橋樑,在 Data Switch 中會決定來自 Application 的資料需求是要 pass 給 server,或是在 local 端進行處理。

因此,在考量系統中的哪些部分必須加入離線(Offline)運作的功能,或是何時需要使用到離線運作的功能,就必須實作於 Data Switch 中,此部分則端看系統實際的使用需求了! 有些功能是必須要 on-line 才有意義的,例如:即時通訊;基本上,存取越頻繁的資料越適合移到 local data layer 來處理,這樣可以大大減少 remote connect 的機會,提升系統效能。


離線系統的模式

離線系統的模式,大致上可以分為兩種,一種是讓使用者可以決定何時讓系統連線,何時離線,稱為 Modal;另一種則是會自動偵測網路連線情況來決定處理方式,稱為 Modeless。

當然不同的模式有不同的優缺點,以 Modal 為例,由於 on-line 與 off-line 的情況是由使用者決定,因此程式開發上較為容易,不過若是使用者搞不清楚狀況,可能就會有沒有資料可用的情形發生(在進入 off-line狀況之前忘了先抓取一些資料來用),或是僅有舊資料可用的狀況(一直忘記更新 server 中的資料);而 Modeless 的優缺點大致上跟 Modal 是相反的,因此開發較為複雜。

而開發時要選取何種模式,則是要根據系統實際會運用的狀況以及使用者對電腦系統操作的熟稔程度來決定。


資料同步

開發 off-line 的系統,資料同步是最重要的問題,這個部分有兩種方式可以達成,其中一種是讓使用者決定何時進行讓 local storage 與 server 的資料同步,通常在 UI 上擺著按鈕用來進行此項操作;而另外一種則是系統會自動偵測連線狀況,在不影響正常使用的情況下,每次一部份一部份的將 local storage 與 server 上的資料進行同步

讓使用者自行選擇資料同步時間點的作法是很容易的,但是也必須考慮到使用者對於資訊系統的操作是否瞭解;而比較困難的是自動偵測連線狀況,必須有一個額外的機制來處理資料同步的工作,通常稱為 Sync Engine,以下用一張圖來說明整個架構:


透過上面這張圖,可以看到 Sync Engine 必須與 local database 及 server(Internet) 進行溝通,因此這個部分的開發勢必較為困難,不過由於所有工作使隱藏起來在背景執行,因此不會影響到系統的使用;至於 Sync Engine 如何實作,最主要還是根據系統需求來決定囉!!

2008年2月20日 星期三

Beginning Linux Programming 學習筆記(1) - Library 簡介

簡介

撰寫 C 語言時,除了必須用的 header file 之外,另外一個重要角色,就是 library 了! 而 library 又分為兩種:
  1. static library (副檔名為 .a)
  2. shared library (副檔名為 .so.N)


Static Library

所謂的 static library,其實沒很特別,只是一堆 object file 的集合而已,以下介紹 static library 的用法。

假設有兩個 function 分別位於不同的 file 中:
// ==================== fred.c ====================
#include <stdio.h>

void fred(int arg) {
printf("fred: we passed %d\n", arg);
} //end fred

// ==================== bill.c ====================
#include <stdio.h>

void bill(char *arg) {
printf("bill: we passed %s\n", arg);
} //end bill
另外設計一支程式,使用到上面所定義的 function:
// ==================== program.c ====================
#include <stdlib.h>

#include "lib.h"

int main(void) {
bill("Hello World!");
exit(0);
} //end main
接著是編譯的方式,有幾種方式可以進行編譯:
# (1) 直接將主程式與 function file 一同編譯
shell> gcc -o program program.c bill.c

# (1) 將定義兩個 function 的檔案編譯成 object file
# (2) 將主程式與 object file 一同進行編譯

shell> gcc -c fred.c bill.c ; gcc -o program program.c bill.o

# (1) 將定義兩個 function 的檔案編譯成 object file
# (2) 產生 static library (archive)
# (3) 將主程式與 static library 一同進行編譯

shell> gcc -c fred.c bill.c ; ar -crv libfoo.a fred.o bill.o ; gcc -o program program.c libfoo.a

# (1) 將定義兩個 function 的檔案編譯成 object file
# (2) 產生 static library (archive)
# (3) 將主程式與 static library 一同進行編譯(-L 指定 library directory、-l 指令所要用的 library name)

shell> gcc -c fred.c bill.c ; ar -crv libfoo.a fred.o bill.o ; gcc -o program program.c -L. -lfoo
其中第三種是比較標準的作法,不過其實 gcc 的功能很強,所以在編譯的時候可以省略一些指令卻可以達到相同效果。


Shared Library

談到 shared library 之前,必須先說明 static library 的缺點,就是當很多程式都使用相同的 static library 時,會在 memory 中產生多份相同的 copy,無形之中造成記憶體很多浪費,因此才會有 shared library 的出現。

shared library 存放的位置跟 static library 大致上是相同的,不過副檔名為 .so.N (N 為重新修改的次數)。

使用 shared library,即時同時被多個程式所使用,系統也只要在 memory 中存有一份資料即可,比起 static library 是節省記憶體許多。

而其運作的方式,在一開始時,shared library 是不會被載入 memory 中,而是當主程式執行時(此時主程式被載入 memory 中),將主程式所使參照使用到的 share library 在執行期間載入 memory 中執行。

接著,用來處理主程式與 shared library 參照工作的程式,稱為 ld.so(或是 ld-linux.so.N),而相關設定檔位於 /etc/ld.so.conf 中,若是設定有任何改變,則需要執行 ldconfig 指令重建參照的工作。

最後,若要查詢一個程式執行時所需求的 shared library,可使用以下指令:
shell> ldd program
linux-gate.so.1 => (0xffffe000)
libc.so.6 => /lib/tls/i686/cmov/libc.so.6 (0xb7e89000) # 需求 libc.so 這個 shared library
/lib/ld-linux.so.2 (0xb7fdf000)

2008年2月18日 星期一

PC Assembly Language 學習筆記(7) - Subprograms

Indirect Addressing

indirect address 的用途是在於讓 register 以類似 pointer 的方式來運作,而使用方式上必須用中括號([])包住 register 名稱,以下舉例說明:
mov     ax, [myData]    ;指定以類似 pointer 方式處理
mov ebx, myData ;EBX = &myData
mov ax, [ebx] ;AX = *EBX


The Stack

現在幾乎大多數 CPU 中都已經支援 stack 了,其特色在於 LIFO(Last In First Out),因此在程式中常被用來作為資料暫存以及呼叫 subprogram 之用,

以下分別舉兩個例子說明:

資料暫存

在資料暫存的部分,必須透過 PUSH、POP 兩個指令以及 ESP(stack pointer) register 的搭配;其中 PUSH 會將 ESP 中的位址 - 4,並將內容塞入 [ESP] 的位址;而 POP 則會將 ESP 中的位址 + 4,並將內容塞到指定的地方去;以下用範例來說明:
;假設 EPS 一開始儲存的 memory address 為 0x1000
push dword 1 ;將 1 存於 0x0FFC 的位置,ESP = 0x0FFC(0x1000 - 0x0004)
push dword 2 ;將 2 存於 0x0FF8 的位置,ESP = 0x0FF8(0x0FFC - 0x0004)
push dword 3 ;將 3 存於 0x0FF4 的位置,ESP = 0x0FF4(0x0FF8 - 0x0004)
pop eax ;EAX = 3,ESP = 0x0FF8(0x0FF4 + 0x0004)
pop ebx ;EBX = 2,ESP = 0x0FFC(0x0FF8 + 0x0004)
pop ecx ;ECX = 1,ESP = 0x1000(0x0FFC + 0x0004)
【註】PUSH 的資料長度必須是 double word

呼叫 subprogram

若要透過 stack 來呼叫 subprogram,則必須使用 CALL 與 RET 兩個指令,其中 CALL 為 unconditional jump,會直接跳到所指定的 Label,並將原本他所在的 memory address push 到儲存下一個執行指令位址的 stack 中;而 RET 則是將 stack 中的 memory address pop 出來,並跳回該 memory address。以下用個範例說明:
mov     ebx, input1
;uncondictional jump,跳至 get_int 所在位址,並將原本的 memory address push 到儲存下一個執行指令的 stack 中
call get_int

mov ebx, input2
;uncondictional jump,跳至 get_int 所在位址,並將原本的 memory address push 到儲存下一個執行指令的 stack 中
call get_int

get_int:
call read_int
mov [ebx], eax
ret ;將原本呼叫 subprogram 時所在的 memory address 從 stack pop 出來,以返回呼叫點
透過此種方式,呼叫 subprogram 就更為方便了!


Calling Conventions

在其他高階程式語言中,常常會在呼叫 subprogram 時帶入多個參數,這在底層是如何處理的呢? 答案就是利用 stack。

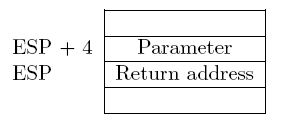
由於參數資料會在 subprogram 中被使用一次甚至數次,因此這些資料不適合放置於 register 中,因此一般會放在 stack 中;而且會在 CALL 指令發生前先 push 進入 stack 中,因此 return address 也會比參數先從 stack 中 pop 出來。以下用一張圖來說明:


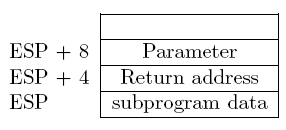
但如果在 subprogram 中又有資料要存入 stack 中呢? 在 stack 中的情形會變成如下:

如此一來,參數的位置就從 [ESP+4] 的位置跑到 [ESP+8] 了,若是在 subprogram 中要使用到 stack,就必須注意參數被移到那個位置去,其實蠻麻煩的。

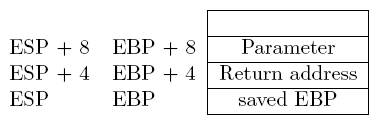
因此,在 80386 以後的 CPU,提供了 EBP(base pointer) register 來解決這個問題,而 EBP 所儲存的內容,則是對應到 return address 所存放的位置(因此一開始 EBP 的內容要設定與 ESP 相同)。

以下用個簡單範例說明 EBP 在 subprogram 中的使用方式:
subprogram_label:
push ebp ;將 EBP 的內容先存到 stack 中
mov ebp, esp ;EBP = ESP
;subprogram 的實作內容置於此處
pop ebp ;還原 EBP 的值
ret
透過以上這一段程式的使用,ESP 與 EBP 的關係會變成如下圖:

之後若要取得參數的內容,不管 stack 中已經塞了多少 subprogram 的資料,只要用 [EBP+8] 就可以取得參數的內容囉!

以下用個範例來進行以上說明的總結:
%include "asm_io.inc"

segment .data
sum dd 0 ;定義記憶體空間,長度為 double word

segment .bss
input resd 1

;
; pseudo-code algorithm
; i = 1;
; sum = 0;
; while(get_int(i, &input), input != 0) {
; sum += input;
; i++;
; }
; print_sum(sum);
segment .text
global asm_main
asm_main:
enter 0, 0
pusha

mov edx, 1 ;將 EDX 視為變數 i
while_loop:
push edx
push dword input
call get_int
add esp, 8 ;將 i 與 &input 從 stack 中清除

;判斷輸入的值是否為 0
mov eax, [input]
cmp eax, 0
je end_while

add [sum], eax ;sum += input

inc edx ;i++
jmp while_loop ;繼續執行下一個迴圈

end_while:
push dword [sum] ;將 [sum] 存入 stack 中
call print_sum
pop ecx ;將 [sum] 從 stack 中清除

popa
leave
ret


;subprogram: get_int
;參數(根據順序放入 stack 中)
; 1、輸入的值(位於 [EBP + 12])
; 2、輸入資料所存放的位址(位於 [EBP + 8])
;[EBP] 儲存原本 EBP 中的內容
;[EBP + 4] 儲存 return address
;[EBP + 8] 之後開始儲存參數的相關內容,因為有兩個參數,因此 ESP 要存取第一個參數就必須指向 [EBP + 12]
;注意:
; 在 EAX 與 EBX 中的資料將會被清除
;
segment .data
prompt db ") Enter an integer number (0 to quit): ", 0

segment .text
get_int:
push ebp ;將 EBP 內容暫時存於 stack 中
mov ebp, esp

mov eax, [ebp + 12] ;上面的程式會將 EDX 的值塞到 [EBP + 12] 所儲存的 memory address 中
call print_int ;印出輸入第幾個數字

mov eax, prompt
call print_string

call read_int
mov ebx, [ebp + 8] ;上面的程式會將 input 所在的 memory address 塞到 [EBP + 8],因此 EBP 儲存的為 memory address 而不是整數
mov [ebx], eax ;以類似 pointer 方式將 EAX 的值存到 EBX 所儲存的 memory address 上

pop ebp ;回復 EBP 中的值
ret


;subprogram: print_sum
; 印出總和
;參數:
; (1)所要輸出的總和(位於 [EBP + 8])
;注意:
; 在 EAX 中的資料將會被清除
;
segment .data
result db "The sum is ", 0

segment .text
print_sum:
push ebp
mov ebp, esp

mov eax, result
call print_string

mov eax, [ebp + 8]
call print_int
call print_nl

pop ebp
ret

Local variables on the stack


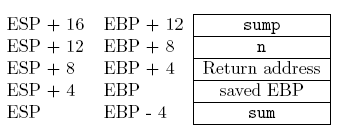
在 subprogram 中,難免會使用到 local 變數,一般都是利用 stack 來處理 local 變數(例如:C 語言),local 變數儲存的地方在原本 EBP 儲存位置之後,以下用一張圖來說明:

(其中 sum 即為 local 變數)

若要取得第一個 local 變數,可透過 [ESP - 4](此時 ESP 指到 EBP 的地方,也就是 +4 的位置),而在 subprogram 中使用 local 變數的方法,可以使用類似以下的程式碼:
subprogram_label:
push ebp
mov ebp, esp
sub esp, LOCAL_BYTES ;在此處根據需求保留給 local 變數的空間
;subprogram 的實作內容置於此處
mov esp, ebp
pop ebp
ret
以下用一個較為完整的範例來說明:
; (C 語言程式碼)
; void calc_sum(int n, int *sump) {
; int i, sum = 0;
;
; for(i = 1 ; i <= n ; i++)
; sum += i;
;
; *sump = sum;
; } //end calc_sum
calc_sum:
push ebp
mov ebp, esp
sub esp, 4 ;保留儲存 local 變數的 memory address 的空間

mov dword [ebp - 4], 0 ;sum = 0;
mov ebx, 1 ;假設 EBX = i

for_loop:
cmp ebx, [ebp + 8] ;i <= n
jnle end_for ;jump if not(less & equal)

add [ebp - 4], ebx ;sum += i
inc ebx
jmp short for_loop

end_for:
mov ebx, [ebp + 12] ;ebx = sump
mov eax, [ebp - 4] ;eax = sum
mov [ebx], eax ;*sump = sum

mov esp, ebp
pop ebp
ret


Multi-Module Programs

所謂的 multi-module program 是由多個 object file 所組合而成的,而之前下一堆指令所產生的執行檔,就是屬於 multi-module program。

而當程式大一點時,總是希望可以將其進行模組化的設計,將龐大的程式拆開成為較小容易閱讀及 debug 的多個檔案,在 assembly 中,可以透過 extern 以及 global 兩個關鍵字。

external

以下先用一段範例程式說明:
extern  read_int, print_int, print_string
extern read_char, print_char, print_nl
extern sub_dump_regs, sub_dump_mem, sub_dump_math, sub_dump_stack
透過 extern 的宣告,用來告知 assembler 以上這些 subprogram 的定義位於外部的檔案中,不在這個檔案中。

不過在編譯的階段必須將包含定義這些 subprogram 的檔案一併加入編譯,否則會產生編譯時的錯誤。

global

global 在之前的每一支程式都會使用到,用意是讓其他的 module 可以直接呼叫使用 global 關鍵字宣告的 module。

使用範例說明

了解兩個關鍵字的使用方式後,接著以下介紹其使用方式:
; ==================== main4.asm ====================
%include "asm_io.inc"

segment .data
sum dd 0

segment .bss
input resd 1

segment .text
global asm_main ;宣告為 global,才可以由 C 程式中直接呼叫使用
extern get_int, print_sum ;宣告為 extern,表示這兩個 subprogram 的定義存在於其他檔案中

asm_main:
enter 0, 0
pusha

mov edx, 1
while_loop:
push edx
push dword input
call get_int
add esp, 8 ;清除兩個參數的內容

mov eax, [input]
cmp eax, 0
je end_while

add [sum], eax ;sum += [input]

inc edx
jmp short while_loop

end_while:
push dword [sum]
call print_sum ;印出在 stack 中的 sum
pop ecx

popa
leave
ret


; ==================== sub4.asm ====================
%include "asm_io.inc"

segment .data
prompt db ") Enter an integer number (0 to quit): ", 0

segment .text
global get_int, print_sum

get_int:
enter 0, 0

;saved EBP(EBP) + return address(EBP + 4) + &input(EBP + 8) + i(EBP + 12)
mov eax, [ebp + 12] ;第一個參數(i)
call print_int

mov eax, prompt
call print_string

call read_int
mov ebx, [ebp + 8] ;取得資料所要儲存的 memory address
mov [ebx], eax ;將資料存於指定的 memory address

leave
ret


segment .data
result db "The sum is ", 0

segment .text
print_sum:
enter 0, 0

mov eax, result
call print_string

;saved EBP(EBP) + return address(EBP + 4) + sum(EBP + 8)
mov eax, [ebp + 8]
call print_int
call print_nl

leave
ret
編譯與執行可用下列指令:
shell> nasm -f elf main4.asm ; nasm -f elf sub4.asm ; gcc -o main4 driver.c main4.o sub4.o asm_io.o; ./main4


Interfacing Assembly with C

之前有提過,由於目前的 compiler 越來越完善,因此編譯出來的 machine code 效能不見得會輸給直接寫 assembly,因此現在已經很少所有程式都使用 assembly 開發了,大多都是在 performance tunning 時,或是需要直接控制到硬體時,才會撰寫 assembly。

因此在使用時,通常都是 C 與 assembly 混合使用,不過有些事情是必須了解的,例如:
  1. C 語言中在 subroutine 中通常都會維護 EBX、ESI、EBP、CS、DS、SS、ES .... 等 register 的值,不會去更動他(但不代表不能更動,只是必須要回復,通常用 stack 來儲存這些 register 中的值)
  2. C 語言中 global 或 static 的 function 或變數名稱前都會加上底線(_),這跟 assembly 中加上底線是不同的意思
  3. 在參數的傳遞上,C call convention 規定 function 中的參數是以反向的順序塞入 stack 中;因此,第一個參數位於 [EBP + 8],第二個參數位於 [EBP + 12] (原本第一個參數位於 [EBP + 12],第二個參數位於 [EBP + 8])
  4. 回傳值的部分大多都是透過將值存於 register 的方式來達成,可能存於 EAX、EDX:EAX、或是 ST0 中
  5. 程式中可以指定不同的 call convention,一般的 compiler 都會支援多種 calling convention

以下用個範例說明 C 與 assembly 的搭配:
// ==================== main5.c ====================
#include <stdio.h>

void calc_sum(int, int *) __attribute__((cdecl));

int main(void) {
int n, sum;

printf("Sum integer up to: ");
scanf("%d", &n);
calc_sum(n, &sum);
printf("Sum is %dn", sum);

return 0;
} //end main


;==================== sub5.asm ====================
%include "asm_io.inc"

; subroutine: calc_sum
; 目的: 計算從 1~n 的加總
; 參數:(因為 C calling convention 的關係,因此參數以反向的順序存入 stack 中)
; (1)加總的上限(即為n) [EBP + 8]
; (2)指向儲存加總資料位址的 pointer [EBP + 12]
; pseudo C code:
; void calc_sum(int n, int *sump) {
; int i, sum = 0
; for(i = 1 ; i <= n ; i++)
; sum += i;
; *sump = sum;
; } //end calc_sum

segment .text
global calc_sum

;local variable:
; sum => [ebp - 4]
calc_sum:
enter 4, 0 ;在 stack 中預留空間給 sum 使用
push ebx

mov dword [ebp - 4], 0
dump_stack 1, 2, 4
mov ecx, 1

for_loop:
cmp ecx, [ebp + 8] ;i <= n ?
jnle end_for

add [ebp - 4], ecx
inc ecx
jmp short for_loop

end_for:
mov ebx, [ebp + 12] ;EBX = sump (儲存加總結果的 pointer)
mov eax, [ebp - 4] ;EAX = sum (加總結果)
mov [ebx], eax ;使用 [pointer] 指定該 memory address 儲存的資料為 sum

pop ebx
leave
ret

然而,從 C 可以呼叫 assembly code,當然也可以在 assembly 中使用 C library 囉! 這個部分下個章節會繼續討論囉!!

2008年2月15日 星期五

PC Assembly Language 學習筆記(6) - Bit Operations

Shift Operations

bit shift 分為三種,分別是 logical shift(用於 unsigned integer)、arithmetic shift(用於 signed integer) 以及 rotate shift

Logical Shift 所用的指令為 SHR(向右位移) 與 SHL(向左位移),位移的最後一個 bit 會存於 carry flag 中。

Arithmetic Shift 所用的指令為 SAL 與 SAR,專門用來處理 signed integer。

【註】Logical Shift 與 Arithmetic Shift 常用於乘二與除二的計算上,速度比 MUL 和 DIV 快上許多!

Rotate Shift 則是將所有 bit 的集合視為一個環狀佇列進行位移,所用的指令為 ROL、ROR、RCL(carry flag 也算佇列中一員)、RCR(carry flag 也算佇列中一員)。

三種 bit shift 的語法都相同,將要位移的資料搬到 register 後,使用類似下方的指令:
# 將 AX register 中的資料向右位移 1 的 bit
shr ax, 1


Boolean Bitwise Operations

最常用的 boolean operation 有 AND、OR、NOT、XOR 四種,在 assembly 中指令也是相同的名稱,使用方式就是將要處理的資料搬入 register 中,再跟另外一個數值或 register 進行 boolean operation。

以下舉個範例:
mov ax, 0x123H or ax, 0E831H
但有幾點必須要注意,NOT 使用後可取得該數值的 1 補數,且不會改變 EFLAGS register 中的值。

另外,AND、OR、XOR 的用途通常在於:
  • AND:關閉某幾個 bit
  • OR:打開某幾個 bit
  • XOR:取得指定 bit 的補數(特殊用法:同樣數值進行 XOR 結果為 0)


Avoiding Conditional Branches

一般在程式中會有許多條件判斷,而 CPU 中有特定的單元可以負責預測程式的走向(不一定每次會準確),若是太多條件判斷,CPU 誤判的機會就越高,執行效率也就越差。

因此,在 assembly 的撰寫中可以避免 conditional branch 的情況發生,可以用 SETxx 指令,以下用個範例來說明:
;檔案: max.asm
;描述:求兩數之間較大的數

%include "asm_io.inc"

segment .data
message1 db "Enter a number: ", 0
message2 db "Enter another number: ", 0
message3 db "The larger number is ", 0

segment .bss
input1 resd 1 ;第一個輸入的數字

segment .text
global asm_main
asm_main:
enter 0, 0
pusha

mov eax, message1 ;取得使用者第一個輸入的整數值
call print_string
call read_int
mov [input1], eax

mov eax, message2 ;取得使用者第二個輸入的整數值
call print_string
call read_int

;一連串為了取得兩數之間的較大值所必須要作的處理
xor ebx, ebx ;EBX=0
cmp eax, [input1] ;比較的結果會影響後續程式的進行
setg bl ;EBX = (input2 > input1) ? 1 : 0 (set 1 if greater)
neg ebx ;EBX = (input2 > input1) ? -1(0xFFFFFFFF) : 0
mov ecx, ebx ;ECX = (input2 > input1) ? -1(0xFFFFFFFF) : 0
and ecx, eax ;ECX = (input2 > input1) ? [intpu2] : 0
not ebx ;EBX = (input2 > input1) ? 0 : -1(0xFFFFFFFF)
and ebx, [input1] ;EBX = (input2 > input1) ? 0 : [input1]
or ecx, ebx ;ECX = (input2 > input1) ? input2 : input1

mov eax, message3
call print_string
mov eax, ecx
call print_int
call print_nl

popa
mov eax, 0 ;回到 C 程式
leave
ret


Big and Little Endian Representations

假設要表示 double word - 0x12345678,兩種表示法分別如下:
  • Big Endian:0x 12 34 56 78
  • Little Endian:0x 78 56 34 12

通常會需要注意到 big/little endian 問題是在寫 TCP/IP 相關程式的時候,在 C 語言中,提供了 htonl() 與 ntohl() 兩個 function 作為 network byte order 與 host byte order 之間的轉換。

而在 486 的 CPU 中提供了兩個指令用來可以反轉 32-bit register 與 16-bit register 的 byte order 之用,以下為使用範例:
#用於 32-bit register
bswap edx

#用於 16-bit register(將 AH 與 AL 對調)
xchg ah, al

2008年2月11日 星期一

PC Assembly Language 學習筆記(5) - Control Structures

Comparisons

在 assembly 中,若要進行資料的比較,必須使用 CMP 指令,以下是 CMP 指令的使用方式:
cmp vleft, vright
CMP 指令作的,其實就是 vleft - vright,並將比較後的結果存入 EFLAGS register 中(使用到 zero、carry、sign 三個 flag),以下進行詳細的說明:

unsigned integer

對於 unsigned integer 的比對,會使用到 ZF(zero falg) 與 CF(carry flag) 兩個 flag,會有以下三種情況:
  1. vleft = vright
    相減後結果為 0,因此 ZF=1;不會有借位的情形,因此 CF=0
  2. vleft > vright
    相減後結果大於 0,因此 ZF=0;不會有借位的情形,因此 CF=0
  3. vleft < vright
    相減後結果小於 0,因此 ZF=0;會有借位的情形,因此 CF=1

signed integer

對於 signed integer 的比對,則會使用到 ZF(zero flag)、OF(overflow flag) 與 SF(sign flag) 三個 flag,也是會有三種情況:
  1. vleft = vright
    相減後結果為 0,因此 ZF=1;不會有借位的情形,因此 CF=0;結果不為負,因此 SF=0
  2. vleft > vright
    相減後結果大於 0,因此 ZF=0;且 CF=SF
  3. vleft < vright
    相減後結果小於 0,因此 ZF=0;且 CF<>SF

當然會改變 EFLAGS 內容的不僅是 CMP 指令而已,不過若是要進行類似 if 的動作,就必須使用上面的方式。


Branch instructions

branch 指令在 assembly 中,作用就類似高階語言中的 goto,型態有分為兩種,分別是:
  1. unconditional branch
    類似 goto,沒有任何條件判斷就會進行跳躍
  2. conditional branch
    根據 EFLAGS register 中的特定 flag 來決定是否進行跳躍

在 unconditional branch 中,最常用的即為 JMP(Jump) 指令,可以指定跳躍至哪一個 code label 所在的位置,而 JMP 有分為不同三種類型:
  1. SHORT
    此種僅能從所在位置前後跳躍 128 bytes 長度的空間,僅使用一個 signed byte 儲存跳躍的長度與位置,優點是節省記憶體空間。
  2. NEAR
    這是 unconditional/conditional branch 所預設的跳躍類型,可跳躍至同一個 code segment 中的任何空間,最大可跳躍 2(28*2)bytes 或 4 bytes(28*4預設) 可表示長度的空間。
    另外若是指定要跳躍 2 bytes 可表示長度的空間,必須在 JMP 與 code label 之間放入 WORD 關鍵字。
  3. FAR
    可跳躍至不同的 code segment。

接著說到 conditional branch,是依靠在 EFLAGS register 中的特定 bit 來決定是否進行跳躍的,以下用張簡單的圖表來說明:

其中 ZF(zero flag)、OF(overflow flag)、SF(signed flag)、CF(carry flag) 之前都已經有提過,而 PF(parity flag) 則是根據計算結果的 lower 8 bits 中,有奇數或偶數個 bit 被設定為 1 來決定是否設定此 flag。

以下用幾段簡單的範例程式來說明:
;高階程式的撰寫方式
if(EAX == 0)
EBX = 1;
else
EBX = 2;

;轉換為以下的 assembly code
cmp eax, 0 ;比較 EAX 與 0(若相同則 ZF=0,不相同則 ZF=1)
jz thenblock ;ZF=0,跳躍至 thenblock
mov ebx, 2 ;EAX<>0,因此 EBX=2
jmp next ;if 判斷完畢
thenblock:
mov ebx, 1 ;EAX=0,因此 EBX=1
next:
;高階程式的撰寫方式
if(EAX >= 5)
EBX = 1;
else
EBX = 2;

;轉換為以下的 assembly code
cmp eax, 5 ;比較 EAX 與 5(若 EAX=5 則 ZF=1;EAX>5 則 ZF=0, CF=SF)
js signon ;SF=1
jo elseblock ;SF=0, OF=1 (表示 EAX < 5)
jmp thenblock ;SF=0, OF=0 (表示 EAX >= 5)

signon:
jo thenblock ;SF=1, OF=1 (表示 EAX > 5)
elseblock:
mov ebx, 2
jmp next
thenblock:
mov ebx, 1
next:

從上面程式看得出來,真的不是很容易理解,更別說是撰寫了,不過幸好 80x86 提供了一些更簡單的寫法,以下用一張圖表來說明:

以下舉個例子,相信上面的表會比較容易看懂。
#JL(Jump if less than) 等於 JNGE(jump if not greater than and not equal to)
x < y => not(x >= y)
因此上面的程式修改如下:
;高階程式的撰寫方式
if(EAX >= 5)
EBX = 1;
else
EBX = 2;

;轉換為以下的 assembly code
cmp eax, 5
jge thenblock
mov ebx, 2
jmp next
thenblock:
mov ebx, 1
next:


The loop instructions

迴圈(loop)在程式開發中是絕對不可或缺的一環,在 assembly 中,loop 的使用並不困難,指令大致有以下三種:
  1. LOOP
    ECX - 1,若 ECX <> 0,繼續下一個迴圈
  2. LOOPE、LOOPZ
    ECX - 1,若 ECX <> 0 且 ZF=1,繼續下一個迴圈
  3. LOOPNE、LOOPNZ
    ECX - 1,若 ECX <> 0 且 ZF=0,繼續下一個迴圈

後兩個 loop 常用於 sequential search 中。

以下用一段範例程式來說明:
;高階程式的撰寫方式
sum = 0;
for(i = 10 ; i > 0 ; i--)
sum += i

;轉換為以下的 assembly code
mov eax, 0
mov ecx, 10
loop_start:
add eax, ecx
loop loop_start


Translating Standard Control Structures

以下要用幾個範例來展示如何將高階語言中的流程控制語法轉換為 assembly code:

IF
;高階程式的撰寫方式
if( condition )
then_block;
else
else_block;

;轉換為以下的 assembly code(兩個分號表示程式擺放的位置)
;;此處擺放用來設定 EFLAGS register 內容的程式
;;例如:cmp xx, xx
jxx else_block ; 判斷為 false
;; 判斷為 true 後所要執行的程式碼
jmp end_if
else_block:
;; 判斷為 false 後所要執行的程式碼
end_if:
while loops
;高階程式的撰寫方式
while( condition ) {
迴圈執行的內容;
}

;轉換為以下的 assembly code(兩個分號表示程式擺放的位置)
while:
;;此處擺放用來設定 EFLAGS register 內容的程式
;;例如:cmp xx, xx
jxx end_while ; 判斷為 false,結束迴圈
;; 迴圈執行的內容
jmp while
end_while:
do while loops
;高階程式的撰寫方式
do {
迴圈執行的內容;
} while( condition );

;轉換為以下的 assembly code(兩個分號表示程式擺放的位置)
do:
;; 迴圈執行的內容
;;此處擺放用來設定 EFLAGS register 內容的程式,例如:cmp xx, xx
jxx do ; 判斷為 true,繼續執行迴圈


範例程式(求質數)

接著介紹求質數的範例,以下為 C code:


接著以下為 assembly code:
;檔案: prime.asm
;描述:求質數

%include "asm_io.inc"

;初始化資料
segment .data
Message db "Find primes up to: ", 0

;未初始化資料
segment .bss
Limit resd 1 ;尋找質數的上限
Guess resd 1 ;目前正在處理判斷的數值

segment .text
global asm_main
asm_main:
enter 0, 0 ;程式開始
pusha

mov eax, Message ;印出訊息
call print_string
call read_int ;讀取使用者輸入的數值,存入 Limit
mov [Limit], eax

mov eax, 2 ;印出 2 與 3
call print_int
call print_nl
mov eax, 3
call print_int
call print_nl

mov dword [Guess], 5

while_limit:
mov eax, [Guess]
cmp eax, [Limit] ;比較 Guess 與 Limit
jnbe end_while_limit ;Guess > Limit,程式結束

mov ebx, 3 ;在 EBX 中設定第一個因數(factor)為 3

while_factor:
mov eax, ebx
mul eax ;EDX:EAX = EAX * EAX
jo end_while_factor ;EAX 相乘後的值無法存入 32-bit 的 EAX register(註解也無所謂,只要不要輸入過大的值即可)
cmp eax, [Guess]
jnb end_while_factor ;if !(factor * factor < guess)
mov eax, [Guess]
mov edx, 0
div ebx ;EDX = EDX:EAX % EBX
cmp edx, 0 ;檢查餘數是否為 0
je end_while_factor ;if(guess % factor == 0)

add ebx, 2 ;factor += 2
jmp while_factor

end_while_factor:
je end_if
mov eax, [Guess] ;印出質數
call print_int
call print_nl

end_if:
add dword [Guess], 2 ;guess + 2
jmp while_limit

end_while_limit:
popa
mov eax, 0 ;回到 C 程式
leave
ret