2008年11月20日 星期四

[Oracle] 交易控制初探

何謂交易? 這一篇文章寫得不錯,可以參考一下…

在 Oracle 中,控制交易的敘述有三個,分別為:

COMMIT

保存對資料的所有更動,清除交易中所有的 savepoint,並釋放對交易的鎖定。

ROLLBACK

復原目前交易中已經完成的工作,也就是最後一次的 COMMIT 之後所有的對資料的變更都會被回復。

SAVEPOINT

可以讓使用者自訂復原的點,這可以讓 ROLLBACK 不會一次全作,而是只復原到特定的點。

關於 COMMIT 與 ROLLBACK 的使用,其實就是加在要 COMMIT 或是 ROLLBACK 的地方就可以了!

比較特殊的是 SAVEPOINT,以下簡單介紹 SAVEPOINT 的用法。

首先先搜尋 counties 中的資料:

接著執行以下 SQL 指令:

由結果可以很明顯看到,在 SAVEPOINT Belgium 之後被更改的資料都被還原囉!

[Oracle] 連線與資料搜尋

連線至資料庫

一開始 Oracle 安裝完成後,除了系統管理員(SYS、SYSTEM、SYSMAN) 之外,其他帳號都是被鎖住的,因此若是要使用其他帳號登入的話,必須先將帳號解除鎖定,以下示範將帳號「hr」解除鎖定:

在 Oracle 中,schema 的名稱跟 user 名稱是相同的

除了這個跟 SQL Server 與 MySQL 不太一樣,Oracle 也只有一個 database,而分類的方式就是利用 schema 的方式進行分類,然後再用與 schema 名稱相同的使用者名稱進行資料庫的連線。

SID 即為 Oracle database 名稱

在連線資料庫的時候,必須指定 SID,而 SID 指的就是 Oracle database 的名稱;而由於每個 Oracle 只有一個 database,因此 SID 在 Oracle 安裝時就會設定好,並且要記好。


Select + Regular Expression

範例一:搜尋 job_id 的值中包含 man 或是 mgr 且大小寫不拘的員工

詳細使用方式可以參考官方網站說明。


範例二:搜尋 last_name 的值中包含兩個母音字母(a、e、i、o、u)且大小且不拘的員工

其中「\1」代表第一個 pattern,也就是「([aeiou])」。(每個 pattern 都會由小括號包起來)

詳細使用方式可以參考官方網站說明。


範例三:將搜尋結果的電話格式由「nnn.nnn.nnnn」改為「(nnn) nnn-nnnn」


詳細使用方式可以參考官方網站說明。


範例四:搜尋地址的街道號碼(格式可能為「1234」、「123-34」或是「12-34-56」)


其中 regexp_substr() 中的後兩個參數為 1,分別代表「從第一個字元開始搜尋」以及「符合搜尋條件幾次」,詳細使用方式可以參考官方網站說明。


範例五:判斷地址中有幾個空白字元


詳細使用方式可以參考官方網站說明。


範例六:取得地址中諦一個空白所出現的位置索引


其中 regexp_instr() 中的後兩個參數為 1,分別代表「從第一個字元開始搜尋」以及「符合搜尋條件幾次」,詳細使用方式可以參考官方網站說明。


Built-in & Aggregate Function

範例一:搜尋員工在職時間


範例二:列出員工年資


範例三:列出目前系統時間


PS. 搜尋 DUAL table 會被罵 dummy 喔! Orz


範例四: 字串格式化 01 (原本格式範例:「01-7月 -98」)


範例五:字串格式化 02 (原本格式範例:「01-7月 -98」)


範例六:字串格式化 03 (原本格式範例:「2600」)


範例七:將字串轉為數字並進行運算


範例八:同時使用多個 aggregation function


許多 function 都已經內建於 Oracle 中,例如:ROUND、TRUNC、LOWER、UPPER、INITCAP、LTRIM….等等,都可以直接拿來使用。

當然這些 function 的數量很多,很難一一介紹,如果想知道 Oracle 提供了哪些 function 以及要如何使用,可以參考官方網站的文件。


範例九:在 job_id 有 CLERK 字眼的群組中,取得 salary 為 3000 的排名以及多少百分比


範例十:查詢員工與獎金相關資料(使用 NVL 與 NVL2)


範例十一:使用 CASE 函數進行年資調整


CASE 的詳細使用方式可以參考官方網站說明。


範例十二:使用 DECODE 函數進行資料比對與條件判斷


DECODE 的詳細使用方式可以參考官方網站說明。

若要進一步瞭解 Oracle 提供的 Aggregation Function 有哪些,以及詳細的使用方式,可以參考官方網站的文件說明;而 Expression 的部份,可以參考此處。

2008年11月18日 星期二

[Oracle] 入門觀念

管理介面

Enterprise Manager

當 Oracle 11g 安裝完成後,可以透過 Web Enterprise Manager 進行管理,但有一點必須注意! 就是不同台電腦安裝 Oracle 可能會有不同的 port number !

基本上連線資訊會在安裝完成後顯示在安裝完成的畫面上,如果可以當然是要記下來囉! 如果真的忘記了,還是有幾種方式可以查到:

  1. 從 server 端,選「開始 → 所有程式 → Oracle - OraDb11g_home1 → Database Control - orcl」進入 Web Enterprise Manager。

  2. 使用記事本開啟「C:\Oracle\product\11.1.0\db_1\install\portlist.ini」檔,內容可能像下面這樣:

Ultra Search HTTP 連接埠號碼 =5620
Enterprise Manager 主控台 HTTP 連接埠 (orcl) = 5500
Enterprise Manager 代理程式連接埠 (orcl) = 3938

iSQL *Plus

這個管理介面在 11g 版本中已經不存在囉!

參考資料


Oracle 與其他 RDBMS 不同之處

Schema

在 Oracle 中,Schema 與特定的 user 連結,因此通常也直接以該 user 的名稱來命名,但其中包含的是許多資料庫相關物件的集合,包含 table、index、data …. 等等。

以下是官方的英文解釋:

A schema is a collection of database objects.

A schema is owned by a database user and has the same name
as that user.

Schema objects are logical structures created by users to contain, or reference, their data.

Schema objects include structures like tables, views, and indexes.

You can create and manipulate schema objects using Oracle Enterprise Manager.
參考資料

SID

SID 就是資料庫名稱(database name),別想太多了!

以下是英文解釋:

The Oracle System ID (SID) is used to uniquely identify a particular database on a system. For this reason, one cannot have
more than one database with the same SID on a computer system.


帳號相關概念

若是要使用特定使用者帳號,要確定該使用者帳號沒有被鎖定(Lock,在 Oracle 安裝時只有 SYS、SYSTEM、SYSMAN、DBSNMP 四個帳號開放),基本上要有管理者(SYS、SYSTEM、SYSMAN)權限才能開放。

在 SQL Plus 中可以直接變換為管理者連線:

SQL> conn sys as sysdba;
輸入密碼; #此處輸入 sys 的密碼
已連線.


接著就可以將特定的使用者帳號解除鎖定:

#將帳號 SCOTT 解除鎖定
SQL> alter user scott identified by passwordofscott account unlock;

參考資訊


查詢 TableSpace

在 SQL Plus 中輸入以下指令即可查詢:

SQL> select * from v$tablespace;

參考資料


資料庫物件(Database Object)

在 Oracle 中有許多不同的物件,以下列出說明:

Tables

這很常見了,應該不太需要說明了吧!

Views

這很常見了,應該不太需要說明了吧!

Indexes

這很常見了,應該不太需要說明了吧!

Functions

以 PL/SQL 所開發的程式,存於資料庫中,有回傳值。

Procedures

以 PL/SQL 所開發的程式,存於資料庫中,沒有回傳值。

Packages

包含可以在資料庫中儲存與執行的 function 與 procedure。

Triggers

這很常見了,應該不太需要說明了吧!

Types

自訂的資料型態,而這種自訂型態可以指定為 table 中某個 column 的型態;亦即在 Oracle 中,資料型態是可以自訂的,但自訂的型態有效範圍僅限於 schema 中。

Sequences

用來產生唯一的整數值之用;可以透過 sequence 來產生 primary key 的值喔!

[Oracle] 安裝 & 開發環境與工具

安裝方式

Windows 應該就不用說了吧? 直接上官方網站下載安裝就行啦!

要在 Linux 練習的話,可以參考此篇文章,在 Ubnutu 上面安裝 Oracle XE。


開發環境與工具

.NET

PHP

Oracle Application Express

這是一個用來快速開發 web application 的工具,詳情可到官方網站了解。

C & C++

Java

2008年11月17日 星期一

ADO.NET Connection Pooling

何謂 connection pool ?

就是為了要節省開啟、關閉資料庫連線時所造成大量的資源與時間耗損所設計出來的機制。


如何達成以上目的的呢 ?

以下直接引用 MSDN2 的解釋來說明:

Connection pooling reduces the number of times that new connections must be opened. The pooler maintains ownership of the physical connection. It manages connections by keeping alive a set of active connections for each given connection configuration. Whenever a user calls Open on a connection, the pooler looks for an available connection in the pool. If a pooled connection is available, it returns it to the caller instead of opening a new connection. When the application calls Close on the connection, the pooler returns it to the pooled set of active connections instead of closing it. Once the connection is returned to the pool, it is ready to be reused on the next Open call.

從上面可以瞭解,一旦當 connection string 被指定後,ADO.NET 會自動產生多個 active connection 並置於 connection pool 中。

一旦程式中有 connection open() 的動作,就直接從 pool 中拉出一個 active connection 並回傳;若程式中有 connection close() 或是 Dispose() 的動作,則是直接將 connection 歸還給 pool,不會實際將 connection 關閉。

【注意】前提是這些 connection 的 connection string 是一致的,才會使用到同一個 connection pool 所提供的 connection。


Connection Pool 之間是如何區別的呢 ?

以下直接引用 MSDN2 的解釋來說明:

Connections are pooled per process, per application domain, per connection string and when integrated security is used, per Windows identity.

可以知道,connection pool 可以同時不只有一個(若是同時利用兩個不同的 connection string 產生 connection),可以同時有多個存在;而不同 process、不同的 application domain、不同的 connection string、甚至不同的 Windows identity 都會產生不同的 connection pool 來維護各自的資料庫連線。


要如何才能使用 Connection Pool 的功能呢 ?

以下直接引用 MSDN2 的解釋來說明:

Pooling connections can significantly enhance the performance and scalability of your application. By default, connection pooling is enabled in ADO.NET. Unless you explicitly disable it, the pooler optimizes the connections as they are opened and closed in your application. You can also supply several connection string modifiers to control connection pooling behavior.

恩…微軟直接在 ADO.NET 預設開啟 Connection Pooling 的機制了,想要關閉或是進行調整的話,可以在 connection string 中指定。只要指定好 connection string,開始連線時,ADO.NET 就會自動建立 connection pool 供程式使用了!


Connection Pool 中的連線預設都不關閉嗎 ?

以下直接引用 MSDN2 的解釋來說明:

If MinPoolSize is either not specified in the connection string or is specified as zero, the connections in the pool will be closed after a period of inactivity. However, if the specified MinPoolSize is greater than zero, the connection pool is not destroyed until the AppDomain is unloaded and the process ends.

因此可以知道,在 connection string 中的「MinPoolSize」屬性設定,會影響到資料庫連線在 connection pool 中是否會自動關閉。


Connection Pooling 細節的運作機制

以下直接引用 MSDN2 的解釋來說明:

The connection pooler satisfies requests for connections by reallocating connections as they are released back into the pool. If the maximum pool size has been reached and no usable connection is available, the request is queued. The pooler then tries to reclaim any connections until the time-out is reached (the default is 15 seconds). If the pooler cannot satisfy the request before the connection times out, an exception is thrown.

很清楚的,可以知道 ADO.NET connection pooling 的運作機制如下:

  1. 基本上 pooler 會盡量滿足來自程式中資料庫連線的需求。
  2. 但若是到達 pool 所擁有的最大連線數,已經沒有任何 connection 可用時,此時資料庫連線的 request 會存放在佇列中。
  3. 若佇列中有 request 存在,pooler 就會持續的向已經 timeout 的 connection 要求收回連線。
  4. 若在 request timeout 的時限內都還沒有 connection 可用,例外就會發生並拋出。


何謂 Pool Fragmentation ?

常發生在 web application 中,原因是因為在 process 運作的期間產生了太多個 connection pool,因此 web server 必須維護大量的 connection,造成資源的虛耗,此種現象稱為「Pool Fragmentation」。


為何會發生 Pool Fragmentation ?

發生 Pool Fragmentation 可能會有兩種原因:

使用 Windows Authentication 的方式進行使用者認證

有些 web application 會採用 Windows Authentication 的方式認證使用者,而先前提過,使用不同的 windows identity 進行資料庫連線要求時,會產生不同的 connection pool,而當 connection pool 產生時,會預設產生出數個 connection 以供未來資料庫連線要求之用。

因此若要解決這個問題,可以將使用者認證的資訊存於資料庫中,進行認證時,只要統一經由相同的連線向相同的存取認證資訊即可。

同時連結多個資料庫

連結多個資料庫表示 connection string 會不同,當 connection string 不同時,相對的也會產生出不同的 connection pool。

而要解決這個問題,可以透過 SQL 語法中的「USE」關鍵字,直接在同一個連線中轉移資料庫並進行相關資料的擷取。


參考資料

  1. MSDN2 - Connection Pooling (ADO.NET)

  2. 康廷數位: 停用 Connection Pooling 機制

  3. ASP.NET 2.0 網站、Oracle connection pooling 問題 - Huan-Lin 學習筆記

  4. 邱英瑞(Jacky) : 如何證明 ADO.NET 預設有使用 Connection Pooling 的機制

  5. Close, Dispose, using And Connection Pool


實作相關資訊

  1. ADO.NET Connection Pooling Explained | O'Reilly Media

  2. 15 Seconds : Tuning Up ADO.NET Connection Pooling in ASP.NET Applications

  3. CodeProject: ADO.NET Connection Pooling at a Glance.

  4. ADO.NET Connection Pooling at a Glance

2008年11月16日 星期日

[Head First OOAD] 將你的軟體帶進現實世界:分析

  1. 分析幫助你確保系統運作在真實世界的情境裡。
  2. 以對客戶、老闆、與自己合理的方式,撰寫你的使用案例。
  3. 分析與使用案例,讓你對客戶、經理、和其他開發者展示系統在真實世界的情境裡如何運作。

[Head First OOAD] 山可移,此情永不渝...現在,情況有變:需求變更

觀念說明

  1. 從第一步到最後一步通過使用案例的完整路徑,稱為使用情節(scenario)。
  2. 大部分的使用案例有一些不同的使用情節,但總是共有相同的使用者目標。
  3. 任何時候你的使用案例改變,你必須回頭檢查你的需求。
  4. 有時候,需求的變更揭露出關於系統你所不知道的問題。
  5. 變更是常態,隨著你每次的時作,系統總是隨之改善。


常見問題

何謂替代路徑

替代路徑是包含在使用案例裡的一或多個步驟,是選擇性的(optional)或提供替代性的(alternate)方式通過使用案例。

替代路徑可能是增加到主要路徑裡的額外步驟,或是提供步驟,讓你以完全不同於主要路徑的方式,到達使用案例的目標。

可以在相同使用案例中擁有一個以上的替代路徑 ?

你可以有多條替代路徑提供額外的步驟,以及多重條件從起始條件(start condition)通往終止條件(stop condition)。

甚至可以有替代路徑早一點終止使用案例。


重點整理

  • 需求將總是隨專案進行而改變。
  • 當需求變更時,你的系統必須隨之演進,處理新需求。
  • 當你的系統需要以新的或不同的方式運作時,就從更新你的使用案例開始。
  • 一個使用情節是通過使用案例的單一路徑,從開始到結束。
  • 單一使用案例可以有多重使用情節,只要每個使用情節都具有相同的客戶目標。
  • 替代路徑可以是只發生在某些情況下,或者提供完全不同路徑通過使用案例的一部份的步驟。
  • 你應該總是試著避免重複程式碼。那是維護工作的夢魘,並且是系統設計的問題點。

離線編輯 Blogger 的好工具 - Zoundry Raven

最近使用 Google Docs 將文章發佈至 Blogger,但是都發現格式跑掉很多

之前都沒有這種情形.......

所以決定找個好用的工具來處理這個問題,於是就找到了 Zoundry Raven 這一套軟體

看了許多介紹,是蠻多人推薦的離線編輯軟體

有這個需求的人或許可是試試看這一套囉!


參考資料

  1. Zoundry Raven:讓我考慮換掉Windows Live Writer的Blog發佈軟體

  2. Zoundry 推出新一代 Blog 發佈軟件 - Zoundry Raven

  3. Zoundry Raven 軟件更新

  4. Zoundry Blog Writer 升級了,現在叫 Zoundry Raven - 資訊教學網sitename

  5. Zoundry Raven 離線編寫blog的神兵利器 實戰篇 @ Shadow X digitaldevil :: PIXNET 痞客邦 ::

[Head First OOAD] 給客戶所需之物:收集需求

關於使用案例(Use Case)


  1. 系統運作的正確與否是由客戶決定的,因此,假如你漏掉某項需求,或者他們忘了跟你提,系統還是沒有正常運作。


  2. 談到需求時,最好讓客戶自己說。仔細聆聽,注意系統需要作什麼:稍後在整理出系統要如何做那些事。一組好需求不止於客戶告訴你的是,甚至在不尋常或是出乎意料的環境與使用情況下還要能夠確保系總是能運作。

  3. 使用案例是人們對系統為讓某事發生所採取步驟的稱呼。A use case describes what system does to accomplish a particular customer goal.

  4. 使用案例是捕捉新系統或軟體變更的潛在需求之技術。

  5. 每個使用案例提供一個或多個使用情節(scenario),傳達系統如何與終端使用者(enduser)或其他系統互動,完成特定目標。


使用案例可分為三部分


清楚的價值(clear value)


每個使用案例都必須對系統有清楚的價值。假如使用案例無助於客戶達成目標,這個使用案例便沒有什麼價值。


起點與終點


每個使用案例都必須有明確的起點(starting point)與終點(stopping point),某件事開始此流程,然後有條件(condition)指明流程已完成。


外部啟動者


每個使用案例由外部啟動者(external initiator)開啟,有時啟動者是人,有時可能是系統外的任何事物。


使用案例的相關疑問


  1. 使用案例的關鍵要點之一,是把焦點放在完成一個特定目標上;若系統作一件以上的事情,那就需要一個以上的使用案例。

  2. 使用案例企圖幫你了解系統應該作什麼 - 往往可以像別人(例如:客戶、老闆)解釋該系統;因此使用案例應該用簡單、日常生活的語言。

  3. 使用案例與使用案例圖(Use Case Diagram)是不同的。

  4. 使用案例通常是步驟清單,而使用案例圖是以視覺化的方式顯示使用案例。

  5. 使用案例的目的不在於說明如何撰寫程式碼。

重點名詞


External Initiator
:啟動使用案例所描述的步驟清單,沒有它,使用案例是不會開始進行的。

Use Case:幫助你收集好需求,並詳述系統作什麼。

Start Condition:這通常是使用案例的第一步。

Requirement:系統要成功所必須做到的事情。

Clear Value:沒有它,使用案例對人就沒有價值;沒有它,使用案例通常會失敗。

Stop Condition:讓你知道使用案例何時結束。沒有它,使用案例會永遠繼續下去。

Main Path:當一切正常運作時,系統在做的事。這通常是客戶談論系統時所描述的事。


需求


  • 好的需求確保你的系統如客戶所預期的那樣運作。

  • 確認需求涵蓋系統的所有使用案例。

  • 運用使用案例找出客戶忘了告訴你的事情。

  • 使用案例將揭露任何不完整、闕漏的的需求,你可能必須將它們家到你的系統裡。

重點整理


  • 需求是系統為了正確運作所要作的事。

  • 最初的需求通常來自客戶。

  • 為了確保你有一組好需求,要發展出系統的使用案例。

  • 使用案例詳述系統確切應該作什麼。

  • 一個使用案例具有單一的目標,但內含多重的路徑,到達此目標。

  • 好的使用案例具有起始與終止條件、外部啟動者、並且對使用者具有清楚的價值。

  • 一個使用案例就是一則系統如何運作的故事。

  • 對系統要達成的每一個目標,你至少會有一個使用案例。

  • 在使用案例完成後,你可藉由他精鍊並增加你的需求。

  • 確保所有使用案例皆可行的需求清單是一組好的需求。

  • 你的系統必須運作在真實世界裡,而不只是在你預期的狀況中。

  • 當事情有錯時,你必須有替代路徑,到達你的目標。

2008年11月15日 星期六

[Head First OOAD] 偉大軟體由此開始:良好應用程式之基石

開發偉大軟體的三個步驟

  1. 確認你的軟體作客戶要它作的事情 (此步驟把重點放在客戶上,確保應用程式作它應該先作的事。這裡是收集需求(requirement)與分析(analysis)工作所著力之處)

  2. 應用基本的 OO 原則,增加軟體的彈性 (一旦軟體開始運作,你能找出任何可能因疏忽而產生的重複程式碼,並且確認你再使用良好的 OO 編程技術)

  3. 努力達成可維護、可重利用的設計 (得到作它該作之事的良好物件導向應用程式? 是時候了,運用設計模式與 OO 原則,確保你的軟體準備就緒)

enum 的妙用


在 class 的某些屬性,若是只有幾種可能性,則可以用 enum 來處理。

Q1:什麼是 enum ?

Ans
:enum 是列舉型別,C、C++ 或是 Java 5.0 以上都有支援。

以 color 為例,有可能會有 red、blue、yellow、green … 等等,但種類絕對不會有太多種 (特殊應用例外!),這種情況就相當適合使用 enum;簡單來說,只要具有「具有標準範圍或合法值」的特性,都適合用 enum 來表示,可以避免取得壞資料。

以下用一段範例程式碼來說明:


Q2:使用 enum 的好處有哪些呢 ?

Ans
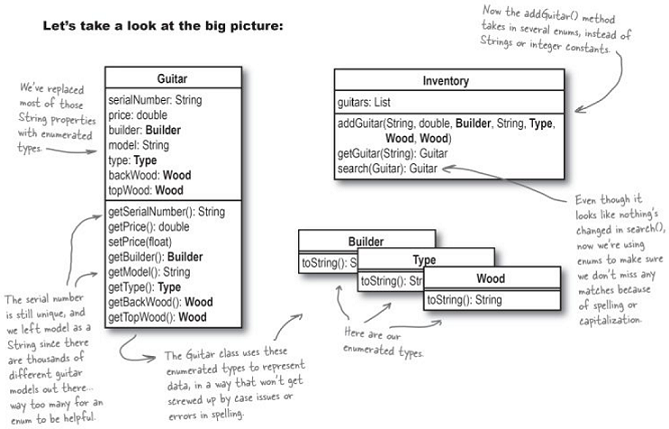
:使用 enum 的 method 或 class,會受到它的保護,確保不會出現未定義在 enum 中的值,即使是打錯或是拼錯,compiler 也會提醒改正。不僅可以確保 type 的安全,也可以確保 value 的安全。

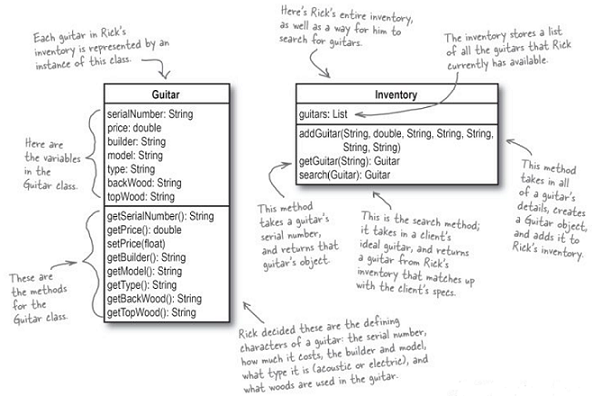
比較以下兩張 class diagram 的設計:

原本的設計


使用 enum 後的改變


基本 OO 原則的思維


1、物件應該作其名稱所指之事

假如物件名稱為 Jet,它可能應該 talkOff() 與 land(),而不應該 takeTicket() - 那是其他物件的工作,不屬於 Jet。

2、每個物件應該代表單一概念

不要讓物件服務雙重或三重責任。避免使用一個 Duck 物件,同時代表會呱呱叫的真正鴨子或是黃色的塑膠鴨。

3、未使用的特性是無用的贈品

假如你有一個物件,經常具有空值或 null 的特性,你可能有一個物件在作一種以上的工作。假如物件中的某個特性很少有值,為何該特性是此物件的一部份? 要不要有一個較好的物件,僅使用原有特性的子集(subset)?

仔細留意前面的 Inventory class diagram,每次顧客要作 search() 的動作時都必須要傳入一個 Guitar 物件,但這個物件的 serialNumber 與 price 永遠都不指定(正是上面第三點說的未使用特性),所以衍生出一個問題:

既然每次都不指定,那可以另外制訂一個 class 來專門處理 Guitar 的規格嗎?

當然是可以的,因為在書中就提出了一個 GuitarSpec 類別來解決這個問題:
看吧! 透過設計一個 GuitarSpec 類別,達成了上述的三個原則!
  1. GuitarSpec 所做的事就只有負責與規格相關的事情,其他一概不管。

  2. GuitarSpec 就是只能代表吉他的規格,也不會突然可以代表小提琴的規格。

  3. 客戶在進行搜尋時,可以專注於規格,無用的 serialNumber 與 price 就可以丟掉囉!

  4. 重點是:程式碼不重複。

委派(Delegation)


委派是當物件需要執行某項工作時,不是直接進行該工作,而是要求另一個物件代為處理。

委派可讓程式碼更能重利用,也讓每個物件關注自己的功能,而不是把處理單一物件行為的程式碼分散在整個應用程式。

委派讓每個物件自己去擔心相等性(或某種其他工作)。這表示物件彼此獨立(鬆散隅合;loosely coupled)。
  1. loosely coupled 的物件可以從一個應用程式取出,並輕易的在另一個應用程式中重利用,因為他們並未緊密繫結到其他物件的程式碼。

  2. loosely coupled 意味著應用程式裡的各個物件各有特定工作要作,而且只作那項工作。

  3. loosely coupled 的應用程式通常比較有彈性,且容易變更。因為每個物件都相當獨立於其他物件,因此可以改變一個物件的行為,而不必牽動所有其他物件,如此一來增加新功能或特色就變的容易多了。

當 GuitarSpec 內容改變時

當 GuitarSpec 中增加屬性(numStrings)時,以先前設計來說,會有什麼結果呢?
解決方式為:
  1. 將與 GuitarSpec 相關的事務都封裝進 GuitarSpec class 中。

  2. 將 Inventory 的 search() method 委派由 GuitarSpec class 來處理。

重點總結


  1. 脆弱的應用程式是很容易出錯的。

  2. 運用類似封裝或是委派的 OO 原則建造有彈性的應用程式。

  3. 封裝將應用程式分解成合乎邏輯的零件。

  4. 委派將處理特定工作的責任轉交給另一個物件。

  5. 總是透過客戶要什麼,來啟動你的專案。

  6. 一旦完成基本功能,就重新精鍊你的設計,讓它有彈性。

  7. 有了符合功能並具有彈性的設計,便能運用設計模式,進一步改善你的設計,讓應用程式更容易重利用。

  8. 找出應用程式經常改變的部分,試著將它們與其他不改變的地方相分離。

  9. 建造運作無誤但設計不良的應用程式,滿足了你的客戶,卻留給自己痛苦,以及無數的修正問題的不眠夜。

  10. 物件導向分析與設計(OOA&D)提供一種產生設計良好之應用程式的方法,同時滿足客戶與程式設計師。

2008年11月12日 星期三

.NET 如何解決 DLL Hell

以下節錄自「別再掉進DLL地獄的陷阱裡(DLL Hell)~.NET解決之道」
  1. The .NET Framework NET Assembly 自我描述與版本管理功能讓 zero-impact 的部署安裝成為可能,同時也終結了DLL Hell。

  2. Application-Private Assemblies (or 被隔離的 assembly) 只能被一個應用程式所使用 - 它不會被其他的應用程式所影響。 隔離的 assembly 讓程式開發者對應用程式有著絕對的控制權,開發好的Application-Private Assemblies只要部署在和應用程式同一目錄即可。

  3. 透過Side by side execution的技術,應用程式只要安裝成功之後,就不用擔心DLL更新版本,或規格的改變, 它允許 一個 assembly 的多個版本在一個機器上同時被安裝並執行, 而且每一個應用程式都可以要求和不同的 Assembly 版本繫結。

  4. The .NET Framework 紀錄應用程式版本資訊,並在執行應用程式時使用此資訊載入應用程式所需依賴的正確版本的 Assemblies。

寫得還不錯的一篇文章,更詳細的內容可以去參考原文囉。

其他參考資料
  1. Josh's Sky- New M Life - DLL Hell

  2. .NET with "DLL HELL"

2008年11月10日 星期一

產生漂亮的 .NET Class 文件

在 Java 中有 JavaDoc 可以協助製作 class 說明文件,那在 .NET 中,當然首推擁有 GUI 介面,並可與 Visual Studio .NET 2005/2008 整合的 DocProject 來製作文件囉!

詳細的安裝與使用說明已經有人寫過囉!

可以參考以下這幾篇文章:
  1. 使用DocProject外速產生.NET物件文件(一)

  2. 小豪的隨想手札 - Visual Studio 2008注解文件的方案

假設要針對 myProject 這個專案產生文件的話,要注意的有兩點:
  1. 在專案的屬性設定中勾選輸出 XML 文件檔案
  2. 從「myProject 專案內」再新增一個 DocProject 專案 (不是在外面重新建一個 DocProject 專案喔!)

如此一來 DocProject 就可以自動產生漂亮的文件囉! 想當然爾........註解也是要寫清楚啦! 不然怎麼會有漂亮的文件可以看呢........

當然裡面還有很多細部設定,想要瞭解的人可以去參考官方網站 的說明囉!

2008年11月9日 星期日

如何在 Blogger 張貼漂亮的程式碼

在「版面配置」的「修改 HTML」中的「</body>」與「</html>」兩個標籤中加入以下 JavaScript 程式碼即可:
<!--  syntax highlighting -->

<link href="http://godleon.googlepages.com/SyntaxHighlighter.css" rel="stylesheet" type="text/css" />
<script src="http://godleon.googlepages.com/shCore.js" type="text/javascript" xml:space="preserve"/>
<script src="http://godleon.googlepages.com/shBrushJava.js" type="text/javascript" xml:space="preserve" />
<script src="http://godleon.googlepages.com/shBrushCss.js" type="text/javascript" xml:space="preserve" />
<script src="http://godleon.googlepages.com/shBrushXml.js" type="text/javascript" xml:space="preserve" />
<script src="http://godleon.googlepages.com/shBrushVb.js" type="text/javascript" xml:space="preserve" />
<script src="http://godleon.googlepages.com/shBrushSql.js" type="text/javascript" xml:space="preserve" />
<script src="http://godleon.googlepages.com/shBrushRuby.js" type="text/javascript" xml:space="preserve" />
<script src="http://godleon.googlepages.com/shBrushPython.js" type="text/javascript" xml:space="preserve" />
<script src="http://godleon.googlepages.com/shBrushPhp.js" type="text/javascript" xml:space="preserve" />
<script src="http://godleon.googlepages.com/shBrushJScript.js" type="text/javascript" xml:space="preserve" />
<script src="http://godleon.googlepages.com/shBrushDelphi.js" type="text/javascript" xml:space="preserve" />
<script src="http://godleon.googlepages.com/shBrushCSharp.js" type="text/javascript" xml:space="preserve" />
<script src="http://godleon.googlepages.com/shBrushCpp.js" type="text/javascript" xml:space="preserve" />

<script type="text/javascript" xml:space="preserve">
dp.SyntaxHighlighter.ClipboardSwf = 'http://godleon.googlepages.com/clipboard.swf';
dp.SyntaxHighlighter.BloggerMode();
dp.SyntaxHighlighter.HighlightAll('code');
</script>

dp.SyntaxHighlighter.BloggerMode();
dp.SyntaxHighlighter.HighlightAll('code');

<!-- end of syntax highlighting -->

使用方式可以參考官方網站的說明喔!


參考資料

  1. Sjcywg's Blog!: Syntax Highlighting

  2. Ticore's Blog: 自改版 dp.SyntaxHighlighter 1.5.1.1

  3. Usage - syntaxhighlighter - Google Code - How to use SyntaxHighlighter.

2008年2月26日 星期二

Beginning Linux Programming 學習筆記(3) - Shell Programming (Shell Syntax)

前言

在 Linux 中,shell 的功能是相當強大的,許多系統管理的功能都可以由 shell 來完成,跟其他程式語言相同,shell 也有其特定語法格式,分成以下幾個部分來說明。


Variables

變數定義的部分,必須注意到引號(單雙引號)的使用與影響,以下用範例來說明:
#!/bin/sh

myvar="Hi there"

echo $myvar
echo "$myvar"
echo '$myvar' #使用單引號就不會印出變數內容
echo $myvar #escape

echo Enter some text
read myvar

echo '$myvar' now equals $myvar
exit 0

# ========== 執行結果 ==========
# Hi there
# Hi there
# $myvar
# $myvar
# Enter some text
# Hello World! <== 這個部分是使用者輸入的
# $myvar now equals Hello World!

接著說明 Environment Variables,這個部分大多數是使用者個人的設定,以下列出幾個常用的環境變數:
Environment Variables
描述
範例
$HOME
使用者家目錄
/home/godleon
$PATH
PATH 設定(由冒號所隔開)
/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin:/usr/games
$PS1
命令提示字元
${debian_chroot:+($debian_chroot)}\u@\h:\w\$
$PS2
命令提示字元
>
$IFS
用來隔開輸入參數的字元,通常為 space、tab 或 newline

$0
shell 的名稱
-bash
$#
傳入參數的數量
2
$$
shell script 所屬的 process ID
5465


繼續是 Parameter Variables,其用途很明顯,當然是跟傳入的參數有關:
Parameter Variables
描述
範例
$1, $2, ......
傳入的參數
para1, para2, .....
$*
所有傳入的參數,以 $IFS 隔開
para1 para2 para3 (假設 $IFS 為一個 space)
$@
所有傳入的參數,不過並非由 $IFS 隔開,而是用一個 space 作間隔
para1 para2 para3

以下用一個範例說明 environment/parameter variables 的使用:
#/bin/bash

salutation="Hello"
echo $salutation

echo "The program $0 is now running" # $0 (shell script 名稱)
echo "The second parameter was $2" # $2 (第二個參數)
echo "The first parameter was $1" # $1 (第一個參數)
echo "The parameter list was $*" # 參數列表
echo "The user's home directory is $HOME" # 家目錄
echo "Please enter a new greeting"
read salutation # 讀取使用者的輸入

echo $salutation
echo "The script is now complete"
exit 0

# ========== 執行結果 ==========
# Hello
# The program try_var.sh is now running
# The second parameter was two
# The first parameter was one
# The parameter list was one two
# The user home directory is /home/godleon
# Please enter a new greeting
# Hello Bash Shell
# Hello Bash Shell
# The script is now complete

Conditions

在 shell script 中可以用 test 指令來測試命令執行後所產生的 exit code,因此在每一個 shell script 的最後一行,建議都加上 exit code 來回應程式執行的結果。

在 shell 中,目前有三種 condition type,分別列表如下:
String Comparison
結果
str1 = str2
True,若 str1 等於 str2
str1 != str2
True,若 str1 不等於 str2
-n str
True,若 str 不為 null
-z str
True,若 string 為 null 或空白字串
Arithmetic Comparison
結果
exp1 -eq exp2
True,若兩個結果相同
exp1 -ne exp2
True,若兩個結果不相同
exp1 -gt exp2
True,若 exp1 大於 exp2
exp1 -ge exp2
True,若 exp1 大於等於 exp2
exp1 -lt exp2
True,若 exp1 小於 exp2
exp1 -le exp2
True,若 exp 小於等於 exp2
! exp
True,若 exp 為 false
File Conditional
結果
-d file
True,若檔案為目錄
-e file
True,若檔案存在
-f file
True,若檔案為一般檔案
-g file
True,若檔案有設定 set-gid
-r file
True,若檔案可讀取
-s file
True,或檔案大小不為 0
-u file
True,若檔案有設定 set-uid
-w file
True,若檔案可寫入
-x file
True,若檔案可執行

以下用一個簡單範例來說明使用方式:
#!/bin/bash

if [ -f /bin/bash ]
then
echo "file /bin/bash exists"
fi

if [ -d /bin/bash ]
then
echo "/bin/bash is a directory"
else
echo "/bin/bash is not a directory"
fi

# ========== 執行結果 ==========
# file /bin/bash exists
# /bin/bash is not a directory


Control Structures

shell 提供了許多不同的控制結構,以下分別一一介紹:

IF
#!/bin/bash

echo "Is it morning? Please answer yes or no"
read timeofday

if [ $timeofday = "yes" ]
then
echo "Good morning"
elif [ $timeofday = "no" ]; then # 請注意此處,必須加上分號以及另外一個 then 喔!
echo "Good afternoon"
else
echo "sorry, $timeofday not recongnized. Enter yes or no"
exit 1
fi

exit 0

FOR


這個部分需要注意一下,變數必須以 space 為間隔!
#!/bin/bash

# 會將 $(ls *sh) 的結果,以 space 為間隔印出
for file in $(ls *.sh);
do
echo $file
done
exit 0

WHILE

#!/bin/bash

echo "Enter password"
read trythis

while [ $trythis != "secret" ];
do
echo "sorry, try again"
read trythis
done
exit 0

UNTIL

#!/bin/bash

# 無使用者登入
until who | grep $1 > /dev/null
do
sleep 60
done

# 偵測到使用者登入
echo "$1 has just logged in"
exit 0

CASE

#!/bin/bash

echo "Is it morning? Please answer yes or no"
read timeofday

case "$timeofday" in
yes)
echo "Good morning";; # 每個 statement 結束都必須用兩個分號
no)
echo "Good afternoon";;
y)
echo "Good morning";;
n)
echo "Good afternoon";;
*)
echo "sorry, answer not recongnized";;
esac
exit 0
#!/bin/bash

echo "Is it morning? Please answer yes or no"
read timeofday

case "$timeofday" in
yes | y | Yes | YES) # 可用 regular expression 一次篩選多個條件
echo "Good morning" # 可執行多個指令
echo "Ip bright and early this morning"
;; # 每個 statement 結束都必須用兩個分號
[nN]*)
echo "Good afternoon";;
*)
echo "sorry, answer not recongnized"
echo "Please answer yes or no"
exit 1
;;
esac
exit 0

LISTs

其實講白了,這個就是 AND & OR
#!/bin/bash

touch file_one
rm -f file_two

# AND 的用法
if [ -f file_one ] && echo "hello" && [ -f file_two ] && echo " there"
then
echo "in if(and)"
else
# 由於 file_two 已經刪除,因此執行到此處
echo "in else(and)"
fi

# OR 的用法
if [ -f file_one ] || echo "hello" || echo " there"
then
# 執行到此處,因為 -f file_one 為 true
echo "in if(or)"
else
echo "in else(or)"
fi
exit 0


Functions

function 的呼叫,除了必須注意是否有回傳值之外,還要注意 global/local variables 的問題! 以下用範例來說明:

沒有回傳值的使用範例:
#!/bin/bash

sample_text="global variable" # 全域變數

foo() {
local sample_text="local variable" # 定義為區域變數
echo "Function foo is executing"
echo $sample_text # 區域變數
}

echo "script starting"
echo $sample_text # 全域變數

foo

echo "script ended"
echo $sample_text # 全域變數
exit 0
有回傳值的使用範例:
#!/bin/bash

# function 的宣告中不會帶參數,必須在呼叫時帶入
yes_or_no() {
echo "Is your name $* ?" # 印出帶入的參數
while true
do
echo -n "Enter yes or no: "
read x
case $x in
y | yes)
return 0;; # 0 表示回傳 true
n | no)
return 1;; # 1 表示回傳 false
*)
echo "Answer yes or no"
esac
done
}

echo "Original parameter are $*"

if yes_or_no "$1" # 帶入第一個參數
then
echo "Hi $1, nice name"
else
echo "never mind"
fi
exit 0


Commands

break

用法其實跟其他程式語言是相同的,作為跳出回圈之用,而 continue 的用法也相同。
#!/bin/bash

rm -rf fred*
echo > fred1
echo > fred2
mkdir fred3
echo > fred4

for file in fred*
do
if [ -d $file ]
then
break; # 效果同 C 語言中的 break
fi
done

echo "first directory starting fred was $file"

rm -rf fred*
exit 0

.
(dot)

dot,透過 dot 會讓在 script 中的指令不會進入 sub shell 執行
# ========== dot.sh ==========
#!/bin/bash

PS2="###"
exit 0


# ========== 執行結果 ==========
# 原本的 $PS2
# shell> echo $PS2
# >

# 一般執行方式
# shell> sh dot.sh
# shell> echo $PS2 # 進入 sub shell 執行,因此還是沒有修改到 parent shell 中的設定
# >

# 以 dot 方式來執行
# shell> . dot.sh
# shell> echo $PS2
# ###

eval


將組合而成的字串變成有意義的變數
#!/bin/bash

foo=10
x=foo
y='$'$x
echo $y # 輸出 => $foo

# 使用 eval 來處理(類似 * 將 pointer 所代表的值提取出來的功能)
eval y='$'$x
echo $y # 輸出 => 10

export

在 sub shell 中定義環境變數之用
# ==================== export1.sh ====================
#!/bin/bash

foo="The first meta-syntactic variable"
export bar="The second meta-syntactic variable" # export 後即為環境變數

sh export2.sh


# ==================== export2.sh ====================
#!/bin/bash

echo $foo
echo $bar # 只有此行會顯示出內容,因為經過 export

expr


執行類似其他程式語言的基本數學運算處理

一般來說,在 shell programming 中是不能做數學運算的,因為 shell 把所有的值都視為字串(string),不過透過 expr 就可以解決這個問題,以下列出 expr 可以進行的簡單數學運算:
敘述
作用
expr1 | expr2
若 expr 不為 0,則回傳 expr1;反之回傳 expr2
expr1 & expr2或兩者任何一個為 0,則回傳 0;反之回傳 expr1
expr1 = expr2判斷是否相同
expr1 > expr2判斷 expr1 是否大於 expr2
expr1 >= expr2判斷 expr 是否大於等於 expr2
expr1 < expr2派斷 expr1 是否小於 expr2
expr1 <= expr2判斷 expr1 是否小於等於 expr2
expr1 != expr2判斷 expr1 是否不等於 expr2
expr1 + expr2回傳兩者相加的結果
expr1 - expr2回傳兩者相減的結果
expr1 * expr2回傳兩者相乘的結果
expr1 / expr2回傳兩者相除的結果
expr1 % expr2回傳餘數

接著用範例說明:
# x++
x = `expr $x + 1`
x = $(expr $x + 1)

printf


非常類似 C 語言中的 printf,但不支援浮點數的表示
shell> printf "%sn" Hello
Hello
shell> printf "%s %dt%s" "Hi there" 15 people
Hi there 15 people

set


在程式中設定參數
#!/bin/bash

echo the date is $(date)

# 設定參數(以 space 為區隔)
set $(date)

# 取第二個參數
echo The month is $2

exit 0


# ========== 執行結果 ==========
# shell> sh set.sh
# the date is 二 2月 26 15:10:00 CST 2008
# The month is 2月

shift


shift 參數之用,常用來瀏覽所有參數
#!/bin/bash

while [ "$1" != "" ]
do
echo $1
# $2->$1 $3->$2 $4->$3
shift
done

exit 0


# ========== 執行結果 ==========
# shell> sh shift.sh 1 2 3
# 1
# 2
# 3

trap


用來指定接收到特殊訊號時的處理動作

訊號(signal)的種類大致可分以下幾種:
訊號
描述
HUP (1)
Hang up (通常在 terminal 離線或使用者登出時會送出此類訊號)
INT (2)
Interrupt (按下 Ctrl + C)
QUIT (3)
Quit (按下 Ctrl + \)
ABRT (6)
Abort (通常程式執行發生嚴重錯誤時會送出此類訊號)
ALRM (14)
Alarm (通常用來處理逾時之用)
TERM (15)
Terminate (通常當機器要關機時,由系統送出)
#!/bin/bash

#若接收到 interrupt 的訊號,以下的命令就會執行
trap 'rm -f /tmp/my_tmp_file_$$' INT

echo creating file /tmp/my_tmp_file_$$
date > /tmp/my_tmp_file_$$

echo "press interrupt (Ctrl+C) to interrupt ...."
while [ -f /tmp/my_tmp_file_$$ ]
do
echo File exist
sleep 1
done
echo The file no longer exists

#即使接收到 interrupt 的訊號,檔案也不會被刪除
trap INT
echo creating file /tmp/my_tmp_file_$$
date > /tmp/my_tmp_file_$$

#因此此處會進入無限回圈
echo "press interrupt (Ctrl+C) to interrupt ...."
while [ -f /tmp/my_tmp_file_$$ ]
do
echo File exist
sleep 1
done

echo we never get here
exit 0


# ========== 執行結果 ==========
# shell> sh trap.sh
# creating file /tmp/my_tmp_file_10581
# press interrupt (Ctrl+C) to interrupt ....
# File exist
# File exist
# File exist <=== 此處按下 Ctrl + C
# The file no longer exists
# creating file /tmp/my_tmp_file_10581
# press interrupt (Ctrl+C) to interrupt ....
# File exist
# File exist
# File exist <=== 此處按下 Ctrl + C

unset


刪除自己設定的環境變數
#!/bin/bash

foo="Hello World"
echo $foo

# unset 後,foo 變數就不存在了
unset foo
echo $foo


# ========== 執行結果 ==========
# shell> sh unset.sh
# Hello World
# (此處為空白)

Beginning Linux Programming 學習筆記(2) - Shell Programming (Pipes & Redirection)

Redirect

在說明 redirect 之前,必須知道 redirect 可以處理的,僅有 file descriptor 0(standard input), 1(standard output), 2(standard error) 三種,接著用例子說明使用方式:
# 將 ls -al 所產生的訊息輸出至檔案 lsoutput.txt 中(檔案內容會被覆蓋)
shell> ls -al > lsoutput.txt

# 將 ls -al 所產生的訊息附加至檔案 lsoutput.txt 中
shell> ls -al >> lsoutput.txt

# 使用可能會產生錯誤訊息的指令(例如 kill)
# 將 standard output 輸出至檔案 killout.txt 中
# 將 standard error 輸出至檔案 killerr.txt 中

shell> kill -HUP 1234 >killout.txt 2>killerr.txt

# 將 standard output & error 輸出到同一個檔案中
shell> kill -1 1234 >killouterr.txt 2>&1

# 不保留任何 standard output & error 相關訊息
shell> kill -1 1234 >/dev/null 2>&1

# 將 mydata.txt 檔案中的內容透過 more 指令呈現 (standard input)
shell> more < mydata.txt


Pipes

pipe 是將前一個 process 處理的結果交給下一個 process 繼續進行處理,藉而達到類似連結多個 process 的效果。

在 Linux 中,連接 process 的數量並沒有限制,並且還能跟 redirect 來搭配同時使用,以下用幾個範例來說明:
# (1) 取得 ps 相關資訊
# (2) 排序後將結果存入檔案 pssort.txt 中

shell> ps | sort > pssort.txt

# (1) 取得 ps 相關資訊
# (2) 排序
# (3) 使用 more 來展示

shell> ps | sort | more

# (1) 取得 ps 相關資訊
# (2) 排序
# (3) 過濾掉重複的 process name
# (4) 清除名稱為 sh 的 process
# (5) 使用 more 來展示

shell> ps -xo comm | sort | uniq | grep -v sh | more

# (1) 使用 cat 讀取 mydata.txt 的內容
# (2) 將內容進行排序
# (3) 過濾掉重複的資料,並將結果存回 mydata.txt
中
shell> cat mydata.txt | sort | uniq > mydata.txt